채팅 성능 고도화 — 채팅 목록 11초를 1.8초로 만든 역정규화
안녕하세요, 숨고 Backend Engineer Neo입니다. 이 글에서는 10년치 데이터가 쌓인 채팅 목록 조회를 역정규화로 개선한 경험을 공유합니다.
숨고의 채팅 목록 API(/api/v2.4/chats)는 고수와 고객의 대화 목록을 불러오는 핵심 엔드포인트입니다. 이름·서비스·지역 키워드로 지난 대화를 찾는 키워드 검색도 이 API가 함께 처리합니다. 개선 전 이 API의 평균 응답 시간은 472ms였습니다.
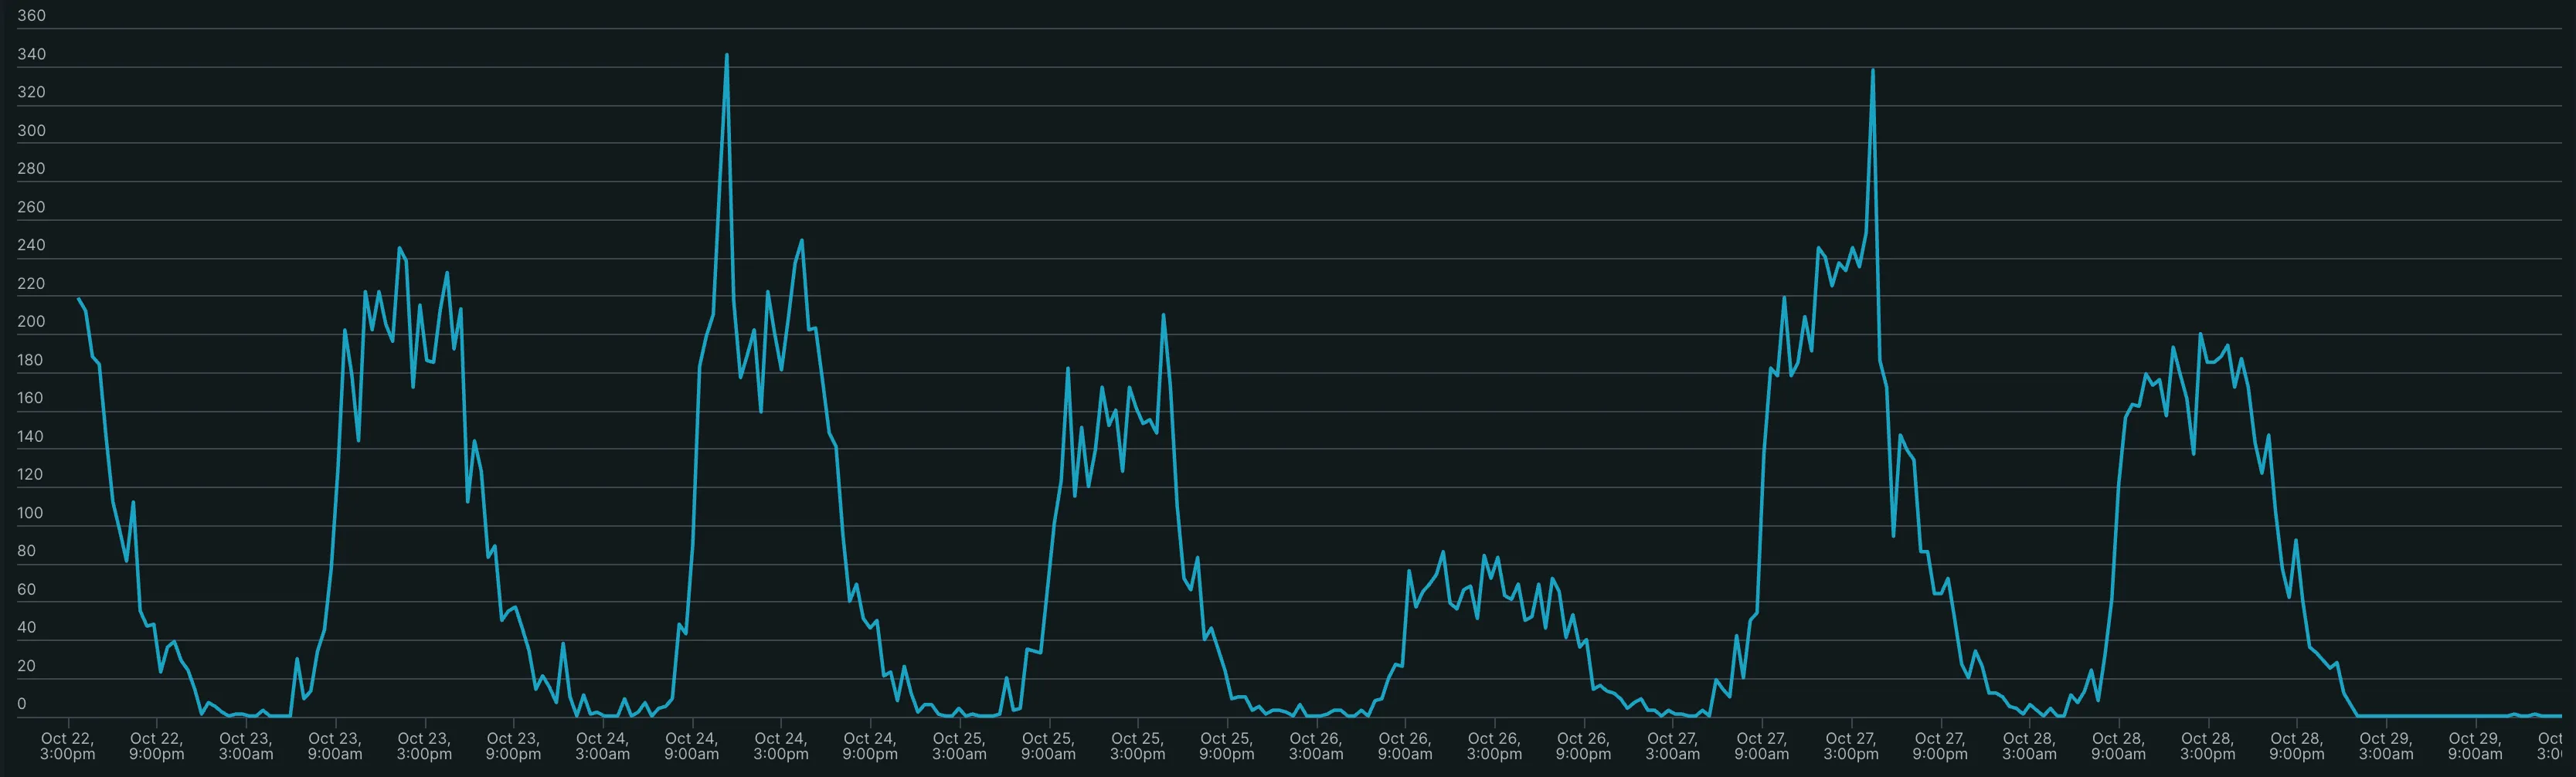
다만 평균 응답 시간이 짧다고 모든 요청이 빠르게 처리 되는 것은 아니었습니다. p99는 5.88초였고, 채널을 3만 개 이상 보유한 고수는 채팅 목록을 여는 데만 약 11초, 키워드 검색을 쓰면 20~39초가 걸렸습니다. 지연은 오전 9시부터 오후 6시, 고수분들이 일하는 시간에 집중됐습니다. 고수분들은 채팅으로 상담하고 견적을 보내기 때문에, 채팅 목록의 지연은 업무에 직접적인 영향을 주는 문제였습니다.
이 글은 그 문제를 10년치 채팅 데이터를 단 한 건도 지우지 않은 채 해결한 과정을 다룹니다. 결과부터 말씀 드리면 평균 472ms → 155ms, p99 5.88초 → 578ms, 채팅 채널을 많이 보유한 고수의 목록 진입 11초 → 1.8초입니다. 개선 폭이 큰 이유는 지연이 데이터량에 비례해 늘어나는 구조였고, 이번 개선이 그 비례 관계 자체를 제거했기 때문입니다. 그래서 지연이 심했던 고수일수록 개선 폭도 큽니다.
다만 이 글의 초점은 결과보다는 의사결정에 있습니다. 인덱스 튜닝으로 해결되지 않은 이유, 샤딩·캐싱·Elasticsearch를 선택하지 않은 이유, 역정규화 문서의 기간 단위를 "한 달의 3분의 1"로 정한 근거, 무중단 마이그레이션 중에 정합성을 지킨 방법을 순서대로 기록합니다.
1. 문제 분석 — 지연은 어디서 오는가
원인을 파악하기 위해 먼저 병목 지점을 데이터로 확인했습니다. New Relic에서 24시간 동안 ChatService의 MongoDB 연동 구간을 살펴보니, channels 컬렉션에 대한 aggregate 연산 하나가 전체 DB 사용 시간의 80.21%를 차지하고 있었습니다. 이 연산의 평균 응답은 57.4ms, 최대는 14.2초였고, 호출 수는 하루 1,430만 건이었습니다.
| Operation | Collection | 호출 수 | 평균 | 최대 | 시간 비중 |
|---|---|---|---|---|---|
| aggregate | channels | 14.3M | 57.4 ms | 14.2 s | 80.21% |
| count_documents | messages | 36.5M | 2.18 ms | 4.56 s | 7.8% |
| find_one | channels | 41M | 1.57 ms | 422 ms | 6.31% |
원인은 데이터가 쌓여 온 구조에 있었습니다. 2018년부터 모든 채널이 삭제 없이 하나의 channels 컬렉션에 쌓여 왔습니다. 이 글에서 '채널'은 고객과 고수가 대화하는 채팅방 하나를 가리키며, 개수를 세는 맥락에서 주로 씁니다. 채팅 목록 조회는 이 컬렉션에서 조회하는 사용자의 유효한 채팅방을 골라낸 뒤, 그 사용자 기준의 마지막 갱신 시각으로 내림차순 정렬하는 aggregate였고, 조회 비용은 그 고수가 가진 채널 수에 비례했습니다.
이러한 비례 관계는 실측으로 확인했습니다. 채널 1만 개 이상을 보유한 고수들을 대상으로 2,382회 측정한 결과, 쿼리 시간은 채널 수와 거의 선형이었습니다(결정계수 R² = 0.90). R²는 결과의 흩어짐을 모델이 얼마나 설명하는지 나타내는 값으로, 0.90은 고수마다 제각각인 쿼리 시간의 차이 중 90%가 채널 수 하나만으로 설명된다는 뜻입니다. 회귀선의 기울기는 채널 1개당 약 0.027ms로, 채널 1만 개가 늘 때마다 약 0.27초씩 느려지는 셈입니다. 이 직선이 1초와 만나는 지점은 채널 34,707개였습니다.

이 직선을 연장하면 채널 40만 개 수준에서 약 11초가 나오는데, 이는 aggregate 연산의 평균 57.4ms와 최대 14.2초의 큰 차이도 같은 결론을 뒷받침합니다. 쿼리 플랜에 문제가 있었다면 평균도 함께 길었을 텐데, 평균은 짧았기 때문입니다. 쿼리 플랜에 문제가 있었다면 평균 응답 시간도 함께 길었을텐데, 평균은 낮았기 때문입니다. 그래서 이 지연을 쿼리 플랜의 문제가 아니라 데이터량에 비례하는 문제로 판단했습니다.
개선 전의 조회 흐름은 다음과 같았습니다. 키워드 검색이 섞이면 MongoDB와 MySQL을 오가며 단계가 더 늘어납니다.
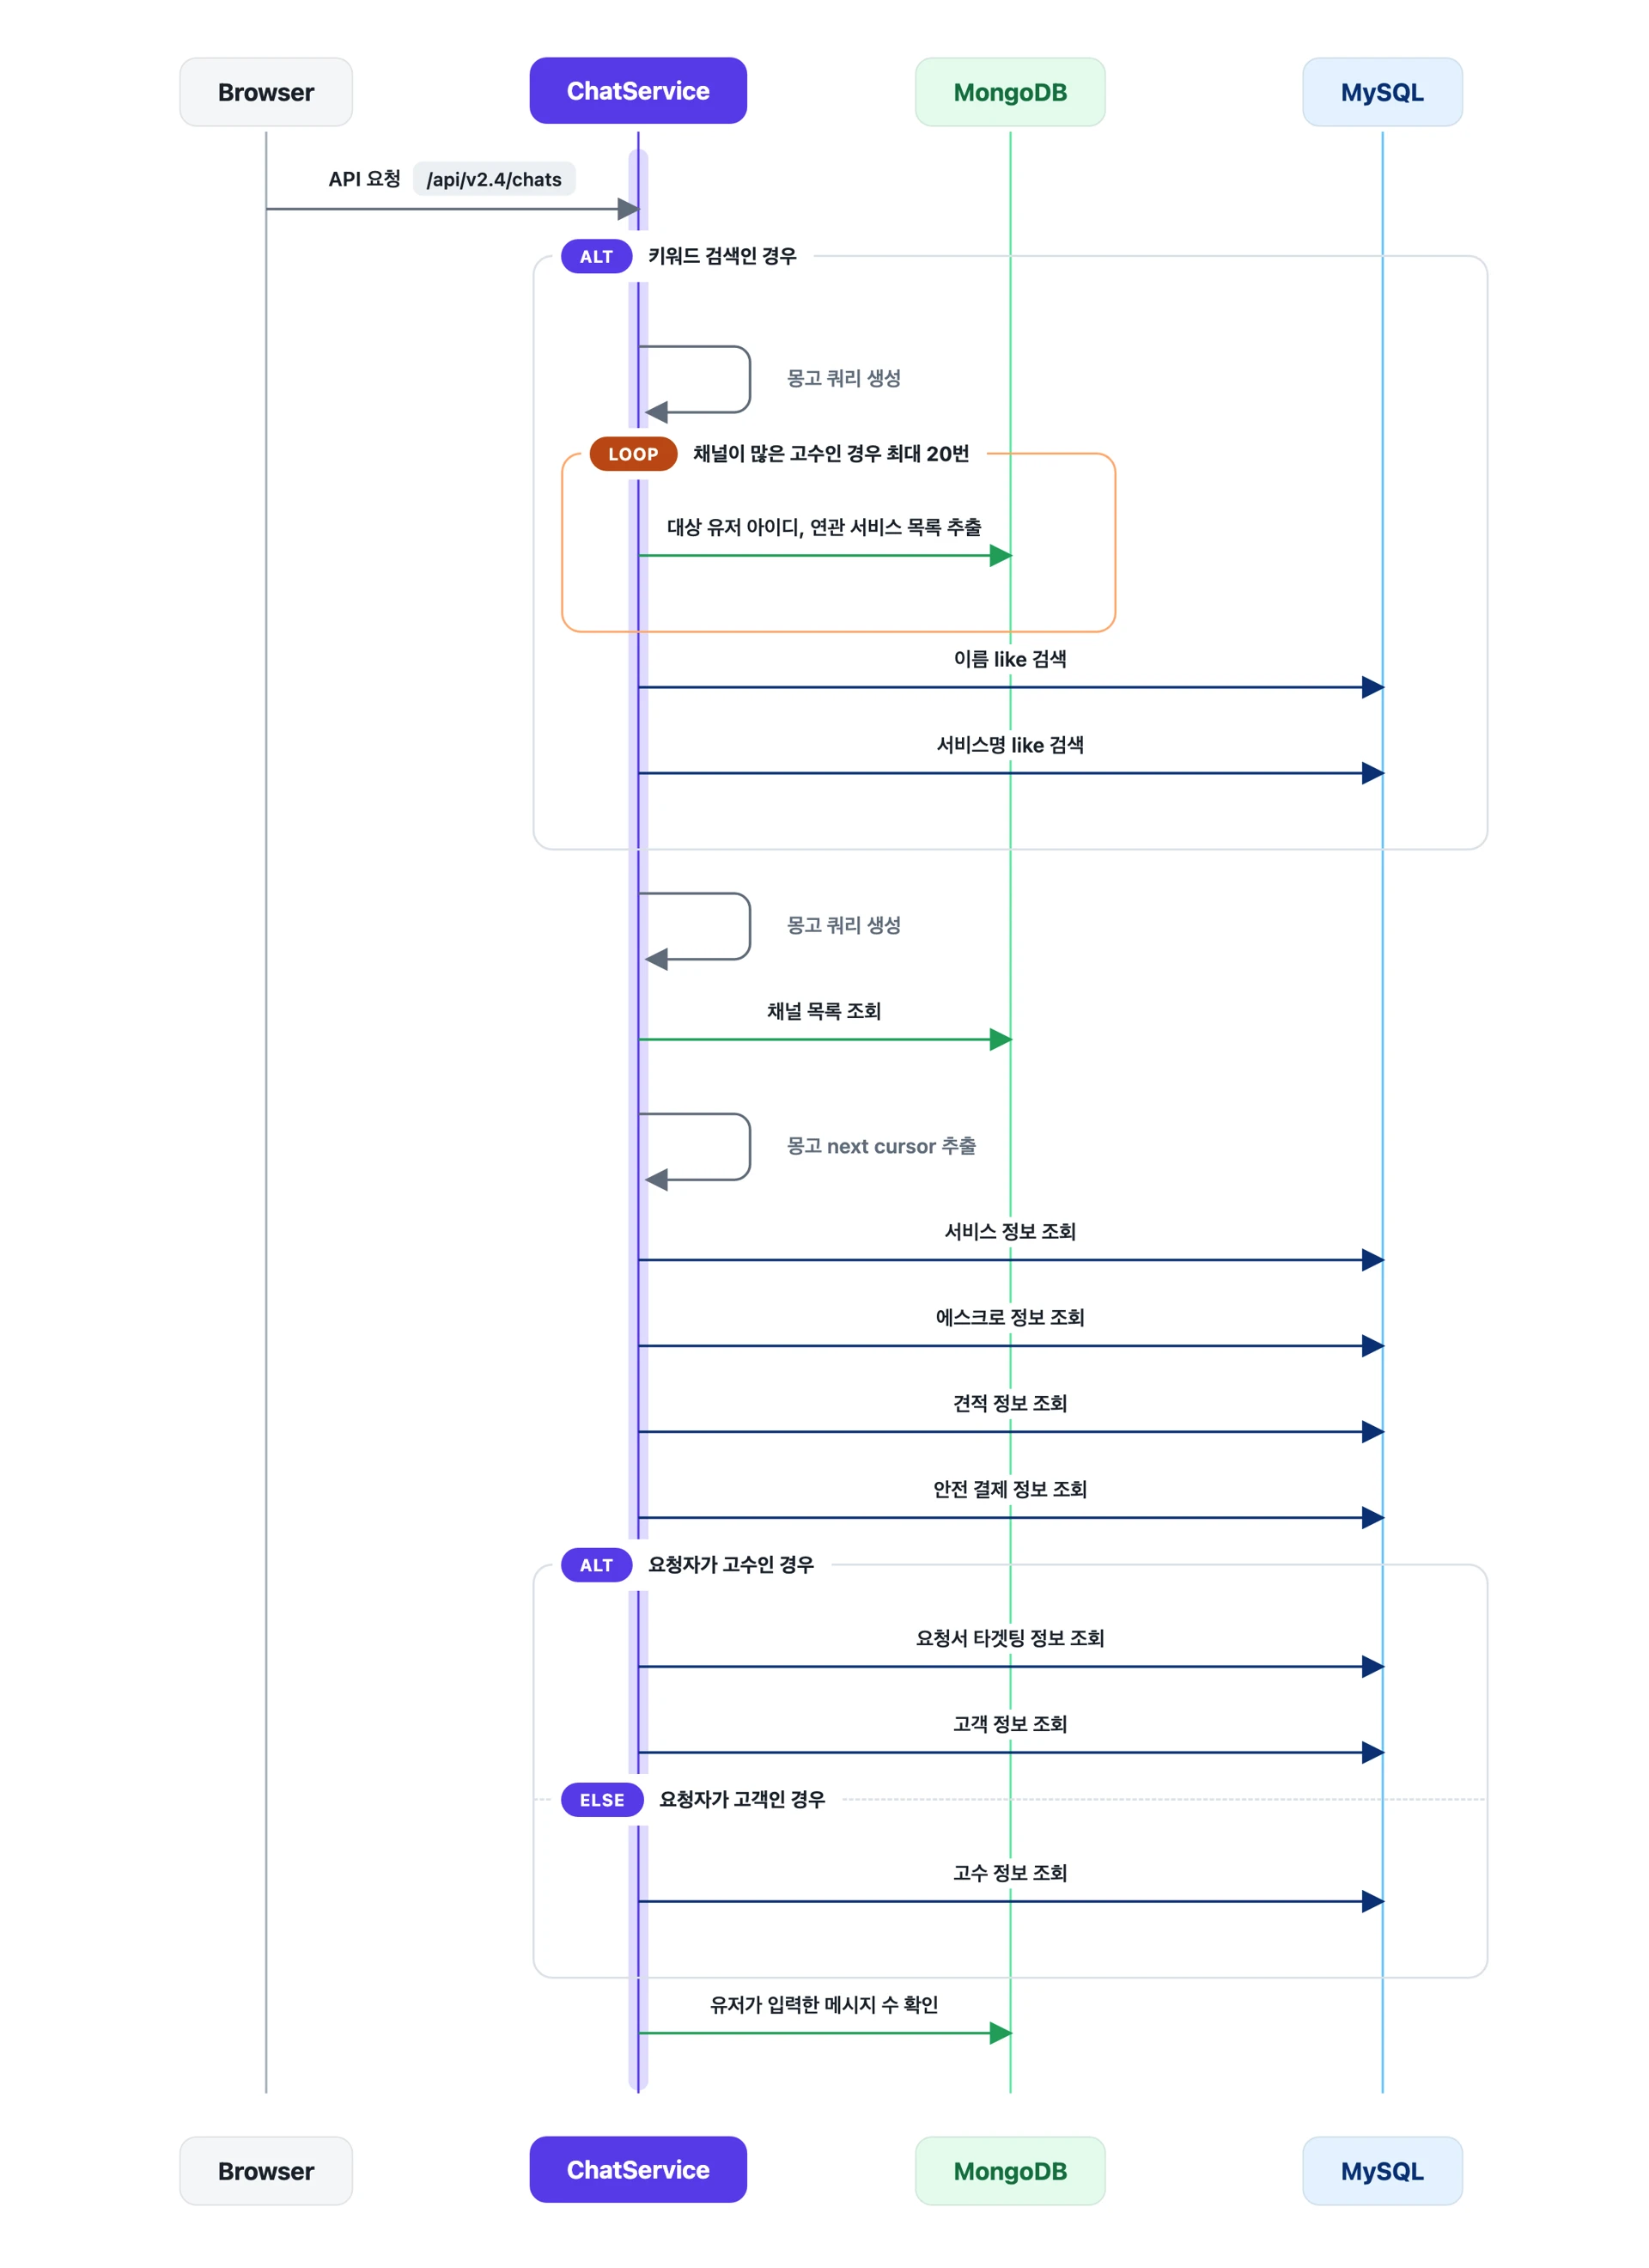
MySQL에도 병목이 있었습니다. 키워드 검색에 쓰이는 사용자 테이블 조회가 최대 1.22초로 MySQL 시간의 22.8%를 차지했습니다. 이름 검색이 LIKE '%키워드%' 형태였기 때문입니다.
문제 해결 과정 1 — 대안 탐색
인덱스 튜닝이 통하지 않은 이유
저희는 먼저 인덱스 튜닝과 중첩 구조 평탄화(문서 depth 축소)를 시도했지만, 큰 성능 향상을 얻지 못했습니다. 그 이유는 쿼리의 실제 형태를 보면 알 수 있습니다.
pipeline = [
    {'$match': {'users': {'$elemMatch': {
        'id': user_id,
        'is_leaved': False,
        'role': role,
    }}}},

    # 조회 결과에 사용자 ID, 서비스 ID, 주소 필드 추가.
    {'$addFields': {'user_ids': '$users.id'}},
    {'$addFields': {'service_ids': '$properties.service_id'}},
    {'$addFields': {'address': {'$concat': [...]}}},

    # users 배열을 개별 문서로 펼치고 "내" 원소 재선택.
    {'$unwind': {'path': '$users'}},
    {'$match': {'users.id': user_id}},

    # 안 읽은 메시지가 있는 문서만 조회할 때 추가.
    # {'$match': {'$expr': {'$gt': [
    #     '$users.latest_message_id',
    #     '$users.last_read_message_id',
    # ]}}},

    # 데이터 변환 후 사용자별 최근 업데이트 순으로 정렬.
    {'$sort': {'users.updated_at': -1}},
    {'$limit': limit},
]
이 쿼리에는 인덱스로 해결할 수 없는 제약이 네 가지 있었습니다.
① 정렬에 인덱스를 쓸 수 없습니다. MongoDB는 파이프라인이 문서를 변환하기 시작하면($addFields, $unwind 이후) 그 뒤 스테이지에서 인덱스를 쓰지 못합니다. $sort가 변환 뒤에 있으므로, 어떤 인덱스를 만들어도 정렬은 항상 그 고수의 전체 채널을 메모리에 올린 뒤 수행하는 blocking sort가 됩니다.
정리하면, 쿼리 플랜을 개선하는 최적화는 문서 하나를 처리하는 비용을 줄일 뿐이고, 채널 수에 비례하는 비용 구조 자체는 바꾸지 못합니다. 이 구조를 없애려면 데이터가 저장된 형태를 바꿔야 한다고 판단했습니다.
② multikey 인덱스의 한계가 있습니다. 정렬 키 users.updated_at은 배열 안에 있습니다. 채널에는 고객과 고수, 두 명의 users 원소가 있고, multikey 인덱스는 "필터에 매칭된 원소의 updated_at으로 정렬하라"를 표현하지 못합니다. 인덱스 엔트리에는 두 사람의 updated_at이 모두 들어가고, 어느 쪽이 조회 주체의 것인지 구분되지 않습니다.
③ 인덱스로 처리할 수 없는 조건이 있습니다. "새 메시지 있음" 필터는 latest_message_id > last_read_message_id, 즉 같은 문서의 필드끼리 비교하는 $expr입니다. B-tree 인덱스는 문서 내부의 필드 대 필드 비교를 지원하지 않습니다.
④ 비용 자체가 채널 수에 비례합니다. 선택적인 필터 키는 users.id뿐이고, 채팅 채널을 많이 보유한 고수라면 인덱스가 수십만 개의 엔트리를 반환합니다. 그 문서들을 전부 가져와야 하는데, 2018년부터 삽입 순서로 쌓인 컬렉션에서 한 고수의 채널은 디스크 전역에 흩어져 있습니다. 랜덤 I/O로 수십만 문서를 fetch하고, 변환하고, 평가하고, 정렬하는 비용은 인덱스가 문서 위치를 찾아 주더라도 그대로 남습니다.
문서 평탄화가 효과를 내지 못한 이유도 같습니다. 중첩 depth를 줄이면 문서 하나를 파싱하는 비용이 조금 줄어들 뿐입니다. 문서 수, 랜덤 I/O, blocking sort, 필드 간 비교 조건이라는 네 가지 제약은 그대로이므로, 채널 수에 비례해 느려지는 경향도 그대로였습니다.
대안 검토 — 샤딩, 캐싱, Elasticsearch
데이터가 저장된 형태를 바꾸는 방법으로 샤딩, 캐싱, Elasticsearch 세 가지를 검토했고, 모두 이 문제에는 맞지 않다고 판단했습니다.
샤딩/파티셔닝 : 샤딩으로 지연을 줄이려면 쿼리가 읽는 범위를 좁혀 주는 분할 키가 필요한데, 이 쿼리에는 그런 키가 없었습니다. 조회 주체인 users.id는 배열 필드라 MongoDB 샤드 키로 쓸 수 없고, top-level 필드로 승격하려면 1억 단위의 문서를 다시 저장해야 합니다. 설령 승격했더라도, 샤딩은 한 고수의 채널을 한 샤드에 모아 줄 뿐이므로 그 샤드 안에서 같은 파이프라인이 같은 양의 데이터를 처리해야 합니다. 시간 기준 분할도 성립하지 않습니다. 정렬 기준인 updated_at이 메시지가 올 때마다 바뀌는 값이라, 시간으로 나누면 문서가 파티션 사이를 계속 옮겨 다녀야 하기 때문입니다. _id 해시처럼 쿼리와 무관한 키로 나누면 조회가 모든 샤드를 읽는 scatter-gather가 되어, 앞서 본 네 가지 제약이 샤드마다 반복됩니다. 결국 샤딩은 처리량을 늘리는 도구이지, 이 문제의 본질인 단일 쿼리의 지연을 줄여 주지는 못했습니다.
캐싱 : 캐싱도 같은 이유로 어렵습니다. 새 메시지가 올 때마다 해당 채팅방이 목록 맨 위로 올라오기 때문에, 첫 페이지 캐시는 메시지가 올 때마다 무효화됩니다. 지연이 문제가 되는 시간대(9~18시)가 메시지가 가장 많은 시간대와 겹치므로, 캐시가 가장 필요한 시간대에 히트율이 가장 낮아집니다. 채팅 목록은 새 메시지가 즉시 보여야 하고 안읽음 수가 정확해야 해서, TTL을 두고 오래된 결과를 보여 주는 방식도 쓸 수 없습니다. 즐겨찾기·고용상태·안읽음·키워드 검색 등 필터 조합마다 캐시 키가 나뉘는 문제도 있었습니다.
Elasticsearch : 키워드 검색이 느리니 검색 엔진을 도입하는 선택지도 있었습니다. 도입하지 않은 이유는 두 가지입니다. 먼저, 기존 ES 클러스터에 이미 데이터가 많은데 채널 데이터가 앞으로 얼마나 커질지 예측하기 어려워, 공유 클러스터에 용량과 성장 리스크를 더하게 됩니다. 더 결정적이었던 이유는 데이터를 관리하는 주체가 MongoDB와 ES 둘로 나뉜다는 점이었습니다. 뒤에서 설명할 역정규화도 데이터를 두 벌로 만들지만, 같은 MongoDB 안의 두 벌은 같은 코드 경로에서 동기적으로 함께 갱신할 수 있고, 정합성이 꼭 필요한 지점에는 트랜잭션도 사용할 수 있습니다(실제로 한 곳에 썼습니다. 정합성 설명에서 다룹니다). 장애 지점과 운영 체계도 하나로 유지됩니다. 반면 MongoDB에서 ES로 데이터를 보내는 구성은 비동기 동기화 파이프라인을 새로 운영해야 하고, 동기화가 밀리면 두 데이터의 차이가 계속 벌어지며, 매핑·리인덱싱·버전업이라는 운영 영역이 추가됩니다. 안읽음 수처럼 메시지가 올 때마다 바뀌는 필드를 자주 부분 갱신하는 것도 ES에 맞지 않는 사용 방식입니다. 무엇보다 문제의 본질이 텍스트 검색이 아니라 정렬과 구조적 필터였습니다.
다만 이 세 가지 아이디어는 최종 설계에 다른 형태로 반영됐습니다. 시간 파티셔닝은 DB 기능이 아니라 애플리케이션 레벨에서 역정규화 데이터에 적용했고, 캐싱은 무효화하는 대신 갱신으로 유지하는 영속적인 뷰의 형태가 됐습니다. 일부 적용에서 전체 적용으로 파트에서 다시 정리합니다.
문제해결 과정 — 역정규화부터 마이그레이션까지
최종적으로 선택한 방법은 역정규화(denormalization)입니다. 원본 channels는 그대로 두고, 조회에 필요한 최소한의 필드만 담은 역정규화 데이터를 따로 만들어, 채팅 목록 조회가 먼저 그곳을 읽게 했습니다.
데이터 모델: (고수 × 기간) 버킷
역정규화 문서 하나는 "한 고수의, 특정 기간의 채널들"을 배열로 모읍니다. 컬렉션은 연도별로 나눕니다(channels_denormalized_2025 등).
{
  "providerUserId": 4444444,
  "keyFromUpdatedAt": 2025090,   // year*1000 + month*10 + period
  "updatedYear": 2025, "updatedMonth": 9, "updatedPeriod": 0,
  "channels": [
    {
      "_id": ObjectId("..."), "userId": 3333333, "svcId": 8888,
      "addr": "서울 강남구 대치동",
      "isHired": false, "isPinned": false, "isIm": false,
      "lastReadMsgId": 555555555, "lastMsgId": 666666666,
      "unreadMsgCnt": 0,
      "updatedAt": ISODate("2025-09-01T01:02:03.040Z")
    }
  ]
}
def calc_period(dt: datetime) -> Literal[0, 1, 2]:
    if dt.day <= 10:
        return 0  # 상순: 1~10일
    elif dt.day <= 20:
        return 1  # 중순: 11~20일
    else:
        return 2  # 하순: 21일~말일

def build_key(dt: datetime) -> int:
    return dt.year * 1000 + dt.month * 10 + calc_period(dt)
이 구조의 목적은 채팅 목록 첫 페이지에 필요한 "최근에 갱신된 채널들"이 소수의 문서에 모여 있게 만드는 것입니다. 조회는 (providerUserId, keyFromUpdatedAt DESC) 인덱스로 최신 버킷부터 읽어 내려가며, 버킷 안에서 정렬과 필터를 거쳐 필요한 만큼만 사용합니다. 원본에서 수십만 문서를 랜덤 I/O로 읽어 오던 작업이 역정규화 데이터에서 문서 몇 개를 읽는 작업으로 바뀌고, 조회가 읽는 데이터의 범위는 전체 채널 수와 무관해집니다. 1장에서 본 "채널 수에 비례하는 지연"이 이 지점에서 사라집니다.
기간을 왜 "한 달의 3분의 1"로 잡았나
한 문서에 어느 기간의 채널을 모을지는 이 설계의 핵심 트레이드오프였습니다. 많이 담을수록 조회 시 읽는 문서 수가 줄어 유리하지만, MongoDB에는 단일 문서 16MB 제한이 있습니다. 지금 데이터뿐 아니라 앞으로 고수당 채널이 늘어날 가능성까지 감안해, 어떤 고수가 얼마나 커져도 절대 한계에 걸리지 않아야 했습니다.
기간 후보는 1년 → 반년 → 3달 → 1달 순으로 좁혀 갔습니다. 채팅 채널을 많이 보유한 고수들의 실제 데이터로 각 단위에서 가장 큰 버킷의 크기를 어림 계산했고, 1달을 다시 상순·중순·하순으로 나눈 것도 같은 계산에 근거한 판단이었습니다. 그 판단을 현재 채팅 채널을 많이 보유한 고수의 데이터로 다시 검산하면 아래와 같습니다. 채널 항목 하나는 약 300바이트로 계산했습니다.
| 버킷 단위 | 최대 버킷의 채널 수(실측) | 문서 크기 추정 | 16MB 대비 |
|---|---|---|---|
| 1년 | 약 12만 | ~36 MB | 2.2배 초과 |
| 1달 | 약 1.2만 | ~3.6 MB | 4.5배 여유 |
| 1/3달 | 약 4,200 | ~1.3 MB | 12배 여유 |
1년 단위였다면 채팅 채널을 많이 보유한 고수는 이미 한계를 2배 넘습니다. 1/3달이면 가장 큰 버킷도 12배의 여유가 있어, 고수당 채널이 상당히 더 늘어도 안전합니다. 기간 계산과 버킷 경계 이동 처리로 로직은 복잡해졌지만, 장기적인 용량 안전을 우선했습니다. 그리고 실제 컬렉션을 복제한 테스트에서, 1/3달치만 모아도 쿼리는 충분히 빨랐습니다.
문서 크기를 줄이기 위한 두 번째 수단은 필드명 약어입니다(svcId, lastMsgId, unreadMsgCnt…). MongoDB 문서에서 필드명은 배열 원소마다 반복 저장되므로, 수천 개 원소를 담는 이 구조에서는 필드명 길이가 문서 크기에 그대로 반영됩니다.
2.3 조회는 2단계: 역정규화 데이터에서 선별하고, 원본에서 본문을 가져온다
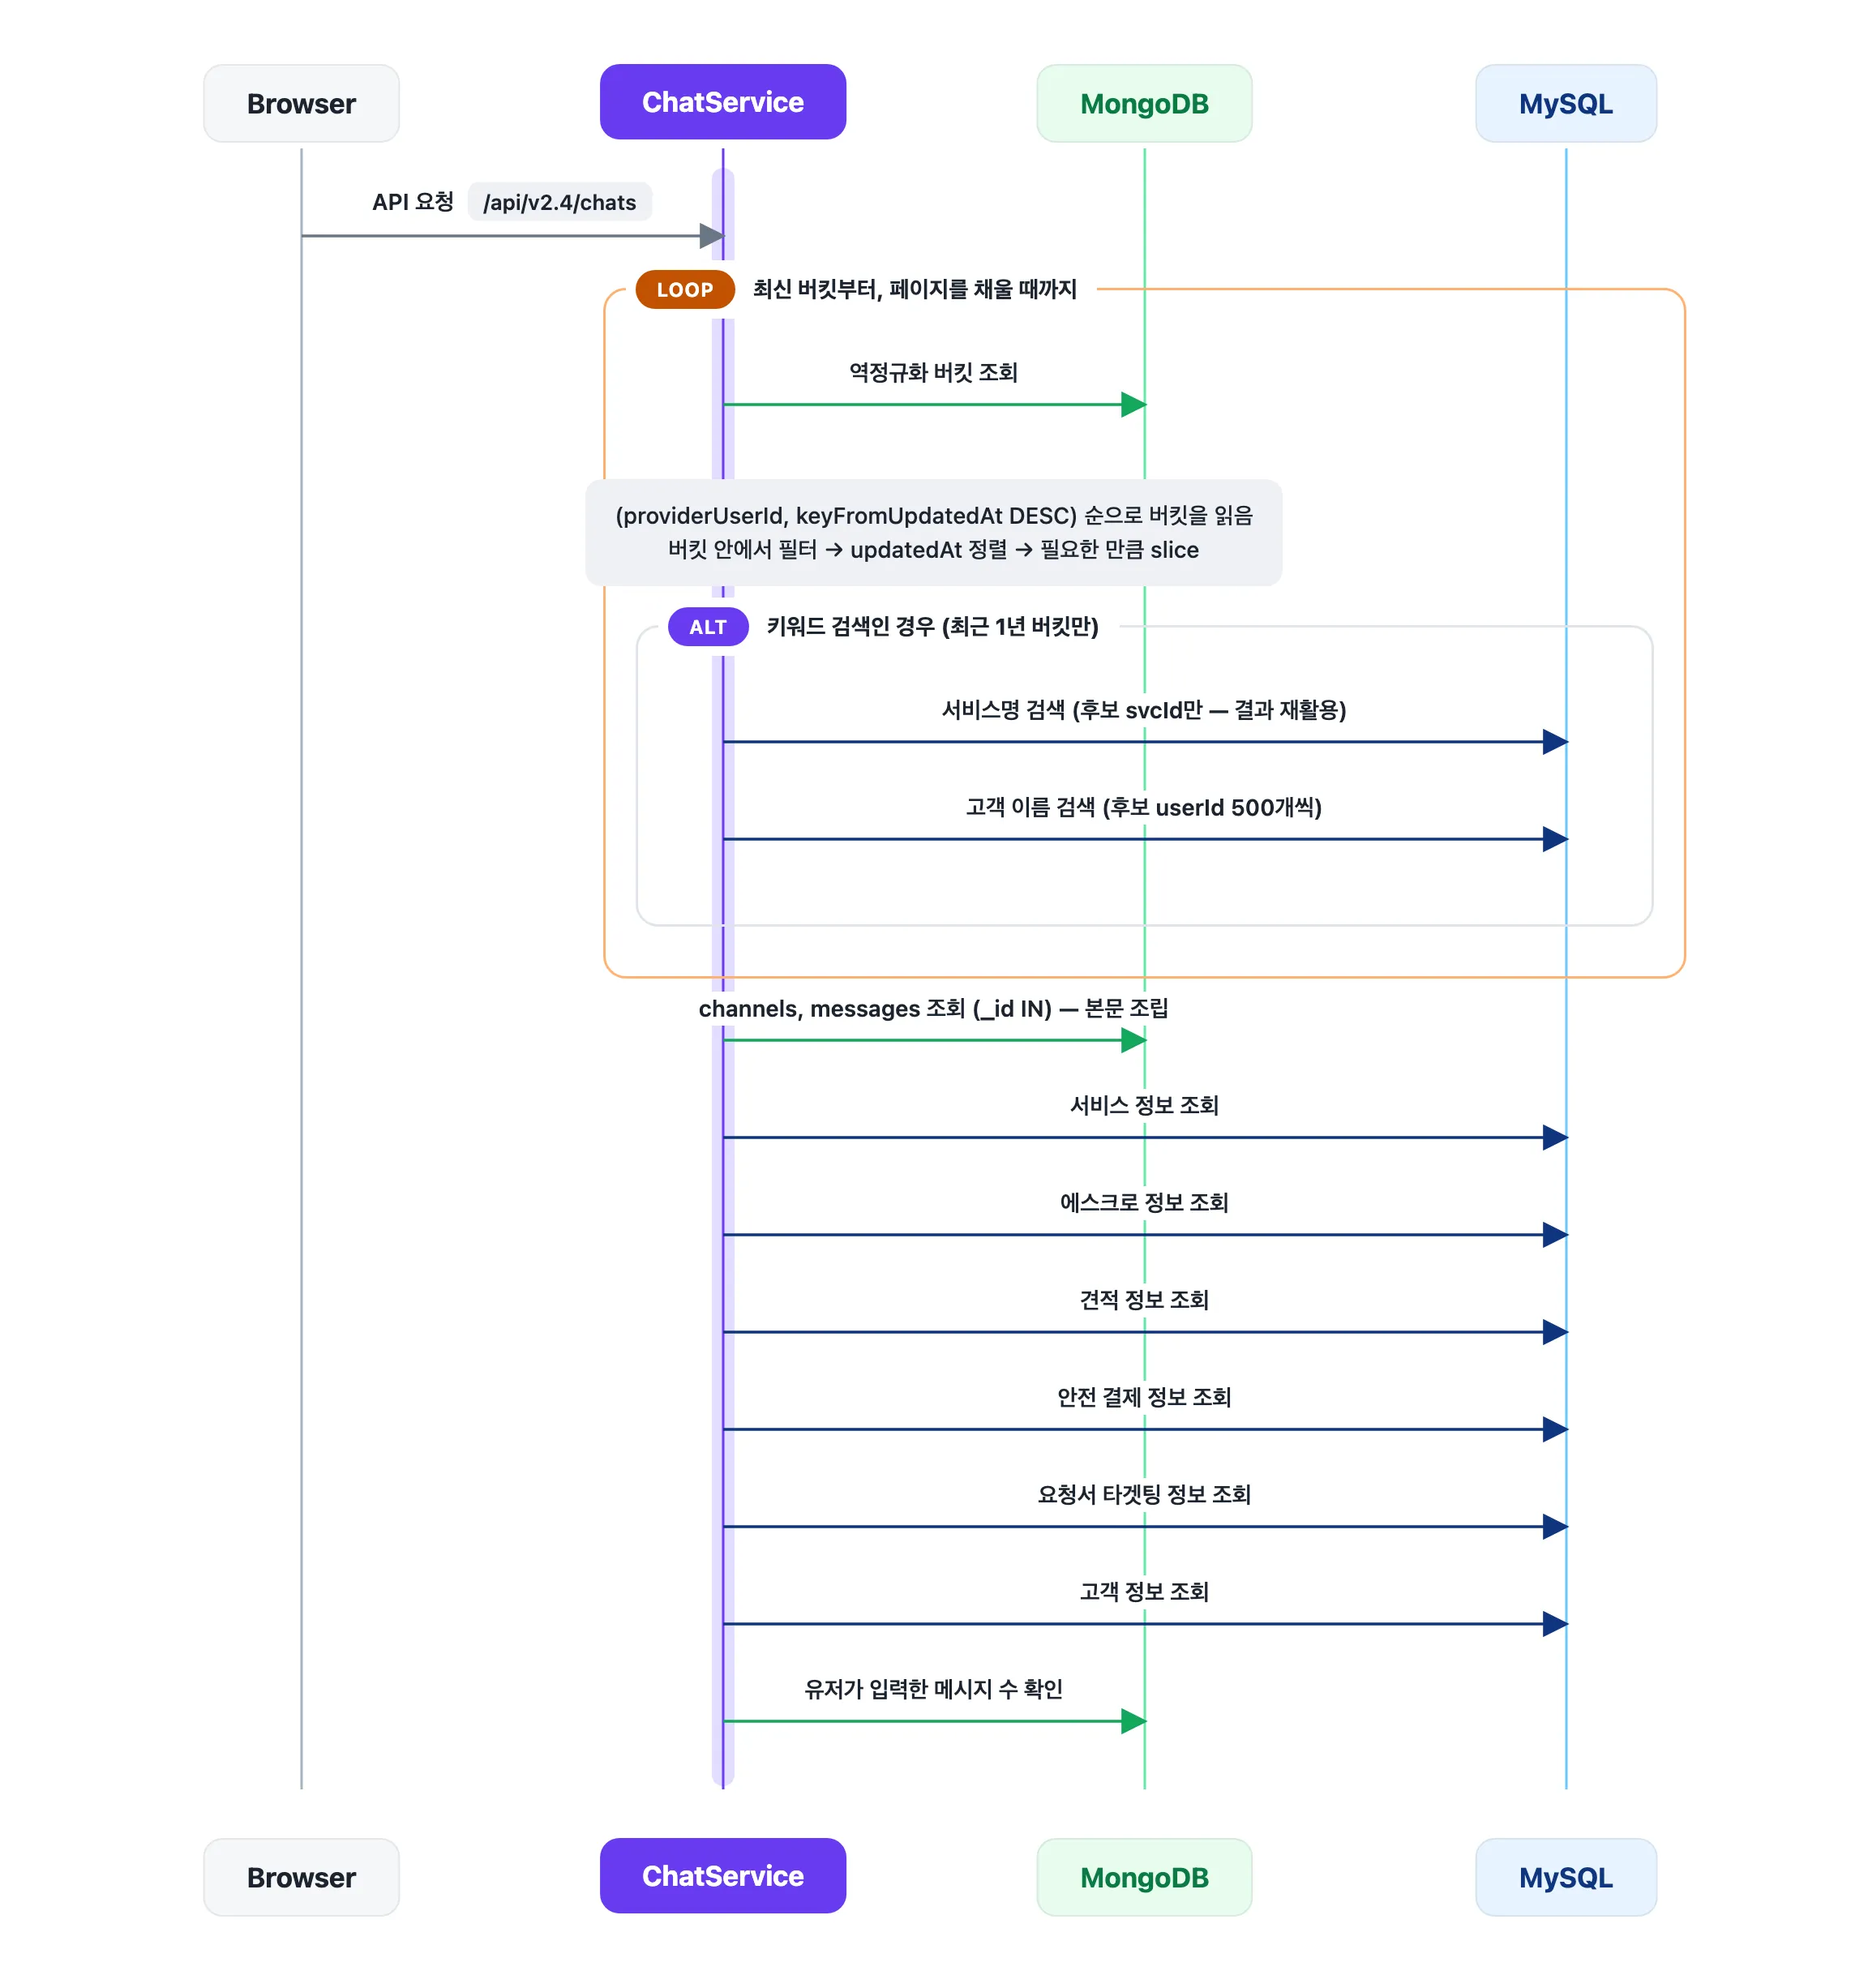
역정규화 문서에는 필터·정렬에 필요한 필드만 있습니다. 조회는 두 단계로 진행됩니다.
역정규화 컬렉션에서 조건에 맞는 채널의 _id를 필요한 개수만큼 추린다 (최신 버킷부터, $sortArray + $slice).
그 _id들로 원본 channels와 messages에서 본문을 가져와 응답을 조립한다.
원본 컬렉션은 어떤 채널을 보여줄지 고르는 일을 하지 않고, 골라진 채널의 본문만 제공합니다. _id로 문서를 찾는 조회는 채널 수와 무관하게 빠릅니다.
2.4 키워드 검색: 범위를 자르고, RDB는 후보만 조회한다
키워드 검색은 이름·서비스명·지역 키워드로 채팅방을 찾는 기능으로, 목록을 불러오는 일반 조회와 구분되는 기능입니다. 이 절에서 설명하는 범위 제한은 키워드 검색에만 적용되고, 본론인 목록 조회는 범위 제한 없이 10년치 전체를 그대로 다룹니다. 키워드 중 이름과 서비스명은 RDB에 있는 데이터라서 이 검색에는 RDB 조회가 필요한데, 기존에는 사실상 전 기간의 채널을 대상으로 LIKE '%키워드%' 쿼리가 실행됐습니다. 이 방식을 바꿀 수 있었던 기반 역시 앞 절의 역정규화 컬렉션입니다. 검색 후보를 고수의 전체 채널이 아니라 최신 버킷부터 좁혀서 꺼낼 수 있게 되면서, 두 가지를 바꿨습니다.
- (구조) RDB에는 후보만 배치로 묻는다 — 역정규화에서 추린 채널들의 서비스 ID·고객 ID를 모아, 서비스명 검색과 이름 검색을 배치 단위(한 번에 500개)로 수행합니다. 고수가 운영하는 서비스 종류는 한정적이라 서비스 검색 결과는 페이지 안에서 재활용합니다
- (정책) 키워드 검색 범위를 최근 1년으로 제한 — 오래된 대화의 검색 수요와 비용을 저울질해 내부 논의로 확정한 정책입니다. 연도별 컬렉션 구조 덕에 "1년 이전 데이터는 아예 안 읽는" 것이 자연스럽게 구현됩니다
키워드 검색의 20~39초 지연은 이 두 가지가 함께 해소했고, 둘 다 역정규화 컬렉션 위에서 가능했습니다. 후보 추출은 버킷 구조가, 1년 제한은 연도별 컬렉션이 가능하게 했습니다. 반면 목록 조회의 11초 → 1.8초는 이 정책과 무관하게, 앞 절까지의 역정규화 구조만으로 이룬 결과입니다.
정합성 — 트랜잭션은 단 한 곳에만
이 설계에서 가장 걱정한 것은 성능이 아니라 정합성이었습니다. 성능은 실제 컬렉션을 복제해 충분히 테스트했기에 확신이 있었습니다. 그러나 새 구조에서는 목록 조회가 역정규화 데이터에 전적으로 의존합니다. 원본 데이터와 역정규화 데이터가 어긋나면 고수의 채팅방이 목록에서 사라지거나 엉뚱한 위치에 보입니다.
원본과 역정규화 데이터의 갱신을 MongoDB 트랜잭션으로 묶는 방법도 있었지만, 새로 만드는 시스템이 기존 쓰기 성능에 영향을 주는 것은 원하지 않았습니다. 그래서 트랜잭션을 최소로 쓰기 위한 준비를 먼저 했습니다.
- 기존 write 쿼리의 단순화 : 오래된 코드베이스에는 의미 없는 분기가 있었고, 한 번의 쿼리로 쓸 수 있는 데이터를 여러 번에 나눠 쓰는 연산도 있었습니다. 분기 케이스마다 테스트를 작성한 뒤 코드를 재작성했습니다
- 흩어진 write의 추상화 : 채널을 쓰는 코드를 한 곳으로 모아, 새 설계를 얹을 때의 변경점을 최소화했습니다
그 결과 트랜잭션이 필요한 지점은 한 곳으로 좁혀졌습니다. 채널을 업데이트할 때 역정규화에 반영할 변화분(delta)을 계산하려면 변경 전 상태와 변경 후 상태를 일관된 한 쌍으로 읽어야 하는데, 동시에 들어오는 다른 쓰기 때문에 이 쌍이 어긋날 수 있는 지점이 그곳뿐이었기 때문입니다.
def update_and_get_before_after(filter_, update, array_filters=None):
    def callback(session, database_name):
        coll = session.client[database_name].channels
        before = coll.find_one(filter=filter_, session=session)
        after = coll.find_one_and_update(
            filter=filter_, update=update, array_filters=array_filters,
            return_document=ReturnDocument.AFTER, session=session,
        )
        return before, after

    with client.client.start_session() as s:
        return s.with_transaction(
            callback=..., read_concern=ReadConcern("snapshot"),
            write_concern=WriteConcern("majority"),
        )
나머지 역정규화 쓰기는 전부 단일 atomic 연산(upsert/replace/$pull)으로 구성했습니다. before/after를 비교해 역정규화 대상 필드가 안 변했으면 건너뛰고, 같은 버킷 안이면 교체하고, 버킷이 바뀌었으면 옛 버킷에서 지우고 새 버킷에 넣습니다.
배포 후 안정성을 판단하는 기준도 정합성으로 잡았습니다. 속도는 New Relic 지표로 확인할 수 있으므로, 역정규화 데이터가 원본과 일치하는지를 적용 대상을 넓혀 가는 동안 계속 점검했습니다. 초기에는 거의 전수로 검사했고, 대상이 늘어난 뒤에는 표본 조사로 전환했습니다.
마이그레이션 — 새벽에, 지연이 큰 고수부터
10년치 채널 데이터를 역정규화하는 백필은 그 자체로 부하가 큰 작업입니다. 실서비스 영향을 최소화하는 두 가지 원칙을 세웠습니다.
- 새벽에만 : 백필 데몬은 상시 떠 있지만, 새벽 1~7시에만 동작합니다.
- 지연이 큰 고수부터 : 견적 수가 많은 고수부터 처리합니다. 이 작업의 목적이 채팅 목록 지연 해소이므로, 채팅 채널을 많이 보유한 고수부터 개선 효과를 받게 한 것입니다.
대상 선정에는 실측 그래프의 1초 교차점(34,707)을 반올림한 35,000을 컷오프로 썼습니다.
# 백필 대상: 견적 35,000개 초과 고수를, 많은 순으로 100명씩
select(ProviderDenormalization.provider_id)
.where(
    ProviderDenormalization.status == Status.DEFAULT,
    ProviderDenormalization.quote_count > QUOTE_COUNT_CUTOFF,  # 35000
)
.order_by(ProviderDenormalization.quote_count.desc())
.limit(100)
백필은 2025년 10월 28일 시작해 11월 17일까지 약 3주간 진행됐고, 60만 명이 넘는 고수가 처리됐습니다. 완료 시각의 99.98%가 새벽 1~7시에 기록되어 있고, 처리 순서가 견적 수가 많은 고수부터였다는 것도 로그로 확인됩니다.
백필 중의 변경 처리 — catch-up 큐
남은 문제는 백필 중에 발생하는 변경이었습니다. 채팅 채널을 많이 보유한 고수 한 명의 백필은 수십만 채널을 처리하는 장시간 작업입니다. 백필이 이미 옮겨 적은 채널이 백필 완료 전에 변경되면, 그 변경은 역정규화 데이터에 반영되지 못하고 유실됩니다.
새벽 저트래픽 시간대의 작업이라 실제로 발생할 확률은 낮고, 이런 경우 대응 없이 넘어가는 선택도 일반적입니다. 그러나 이 유실은 스스로 복구되지 않습니다. 유실된 채널에 다음 업데이트가 오지 않는 한, 잘못된 안읽음 수나 잘못된 정렬 위치가 그대로 남습니다. 게다가 첫 백필 대상은 채팅 채널을 많이 보유한 고수들입니다. 채팅 데이터에 가장 민감하고, 채널이 많은 만큼 백필 시간도 가장 깁니다. 발생 확률은 낮아도 한번 생기면 되돌릴 수 없는 문제라서, 막기로 했습니다.
방법은 온라인 마이그레이션 도구들(gh-ost, AWS DMS, MongoDB initial sync)이 쓰는 snapshot + catch-up 패턴입니다. 이것을 새 인프라 없이 MySQL TEXT 컬럼 하나로 구현했습니다.
- 백필 중(STARTED)인 고수의 채널이 변경되면, 역정규화 데이터에 바로 반영하는 대신 "어떤 채널이, 어느 위치에 있었나"만 큐에 기록합니다 (TEXT 컬럼에 원자적 append)
- 백필의 전체 스캔이 끝나면, 큐를 중복 제거하며 재생합니다. 이때 기록된 변경 내용을 믿지 않고 원본을 다시 읽어 현재 상태로 맞춥니다
이 큐의 특징은 연산 로그(op-log)가 아니라 dirty set이라는 점입니다. "무엇이 어떻게 변했는지"를 재생하는 대신 "무엇이 변했는지"만 알고 원본을 재조회하므로, 큐에 쌓인 순서에 영향을 받지 않고, 언제 재생해도 원본 기준의 현재 상태에 도달합니다.
def catch_up(provider_user_id):
    """백필 동작 중의 변경 사항을 따라잡는다."""
    for work in CatchUpQueue.deserialize(row.catch_up_queue):
        if work.id in done: continue
        done.add(work.id)
        channel = client.channels.find_one({'_id': work.id})  # 원본 재조회
        current = make_denormalized(channel)
        old_key = build_key(work.dt)                           # 기록된 옛 위치
        # 삭제됐으면 옛 위치에서 제거 / 같은 버킷이면 교체 /
        # 버킷이 바뀌었으면 옛 위치 제거 + 새 위치 추가
배포 후 확인해 보니, 3주의 백필 동안 이 큐에 기록된 변경은 5명의 고수에서 8건이었습니다. 새벽 시간대라 발생이 드물 것이라는 예상은 대체로 맞았지만, 0건은 아니었습니다. 그중 1건은 채팅 채널을 많이 보유한 고수의 백필이 진행되는 도중에 발생했습니다. 큐에 기록된 고수 5명 중 채널이 3만 개를 넘는 고수는 이 1명이라 기준을 밝혔습니다..
8건은 작은 숫자입니다. 그래도 catch-up 큐를 만든 이유는 발생 확률이 아니라, 한번 생기면 스스로 복구되지 않는다는 점이었습니다. 큐가 없었다면 이 8건은 채팅 데이터에 민감한 고수분들의 목록에 잘못된 상태로 남았을 것입니다.
8건은 고수 5명에게서 나왔고 그중 채널 3만 개 이상은 1명이라, 규모 수식어를 뺐습니다.
물론 아쉬운 점도 있습니다. 큐로 쓴 TEXT 컬럼에는 64KB(약 1,100건)라는 저장 상한이 있는데, 이를 넘었을 때의 방어 로직을 두지 않았습니다. 새벽 저트래픽이라는 가정에 기댄 것이고 실제 기록도 8건에 그쳤지만, 문서 크기의 16MB 제한처럼 명시적으로 다뤘어야 할 한계였습니다.
점진 전환과 되돌릴 수 있는 구조
백필과 별개로, 새 조회 경로는 처음부터 전면 적용하지 않았습니다. 조회 분기는 다음과 같습니다.
def list(self, user_id, role, limit, cursor, **kwargs):
    if settings.USE_DENORMALIZED_LIST and role == 'provider':   # 전역 kill switch
        if uses_denormalization(user_id):                      # 고수별 게이트
            return list_from_denormalized(...)
    # 기존 경로 (aggregate) — 언제든 이리로 돌아올 수 있다
    return self.mongo_instance.list(...)
안전장치는 두 겹입니다. 환경변수 하나를 전역 kill switch로 두어, 문제가 생기면 배포 없이 전체를 기존 경로로 되돌립니다. 고수별 게이트는 처음에는 백필이 완료된 고수만 새 경로를 타도록 제한했습니다. 설계가 실전에서 검증되기 전까지, 영향 범위를 채널이 많은 고수 중 백필이 끝난 고수들로 한정한 것입니다..
이 밖에도 운영하면서 보완한 것들이 있습니다. 백필·검증 계열의 읽기는 replica로 라우팅해 primary 부하를 줄였고, 이름 검색의 IN절은 500개 단위로 잘라 slow query를 막았고, 채팅 목록의 페이지 크기에 100 상한을 뒀습니다(개선 후에도 남아 있던 소수의 5초+ 응답은 클라이언트가 page_size를 임의로 키운 경우였습니다).
운영 중에 정합성 문제도 겪었습니다. 고객이 채팅방을 나갈 때 고수 쪽 역정규화 데이터까지 삭제하는 버그가 있었고, 그 탓에 고수분의 목록에서 해당 대화가 사라졌습니다. 고객이 이미 떠나 사실상 종료된 대화였는데도 고수분이 곧바로 알아채고 문의할 만큼, 채팅 데이터는 고수분들에게 민감한 데이터였습니다. 원인을 바로 수정하고(고객이 나가도 고수 기준 데이터는 보존), 삭제된 데이터는 복구 스크립트로 복원했습니다. 전체 전환 전이라 영향 범위가 한정된 시점이었습니다.
일부 적용에서 전체 적용으로
처음에 일부 고수에게만 적용한 데에는 두 가지 이유가 있었습니다.
- 가벼운 컬렉션 : 채팅 채널을 많이 보유한 고수의 데이터만 역정규화해 컬렉션을 가볍게 유지하면 쿼리 속도를 더 끌어올릴 수 있습니다.
- 롤백 가능성 : 이 설계가 실제로 통할지에 대한 의문이 남아 있었고, 언제든 되돌릴 수 있는 구조를 우선했습니다.
운영을 이어가면서 두 번째 이유는 해소됐습니다. 정합성 점검 결과와 CS 동향을 근거로 역정규화 조회가 안정적이라는 확신이 생겼기 때문입니다. 그러자 이번에는 일부 적용 구조 자체가 비용이 됐습니다. 역정규화된 채널과 그렇지 않은 채널이 공존함에 따라 두 벌의 데이터와 두 벌의 로직을 유지해야 했고, 이를 유지하는 상태 머신·데몬·catch-up 큐가 계속 동작해야 했기 때문입니다.
그래서 모든 고수의 데이터를 역정규화하는 쪽으로 방향을 바꿨습니다. 컷오프를 낮춰가며 백필 대상을 전체로 넓혔고(처음 250명이던 대상이 60만 명 이상으로 늘었습니다), 거의 모든 데이터의 역정규화가 끝난 시점에 게이트의 의미를 뒤집었습니다.
# 처음: 백필이 끝난(DONE) 고수만 새 경로
if status is Status.DONE: ...

# 전환 후: 기본이 새 경로, 문제 있는 고수만 제외
if ProviderDenormalization.is_enabled(provider_user_id): ...
아직 역정규화되지 않은 잔여 채널은 별도 스크립트로 찾아 채웠고, 그다음 전환을 위해 존재했던 백필 데몬, 상태 머신, catch-up 큐, 견적 수 기준 선별, 마이그레이션 스크립트를 전부 제거했습니다. 전환용 코드는 전환이 끝나면 남겨 둘 이유가 없다고 판단했기 때문입니다.
전체 적용으로 바꾸면서 첫 번째 이유였던 '가벼운 컬렉션'은 일부 포기한 셈이 됐는데도, 속도는 유지됐습니다. (고수 × 기간) 버킷과 연도별 컬렉션 구조에서는 쿼리 하나가 읽는 범위가 컬렉션 전체 크기와 무관하게 한정되기 때문입니다. 전체 데이터를 담아도 쿼리당 비용은 그대로였습니다.
이 시점의 구조를 앞의 대안 검토와 비교해 보면, 기각했던 아이디어들이 형태를 바꿔 들어와 있습니다. 연도·기간 버킷은 결국 updated_at 기준의 시간 파티셔닝입니다. 다만 DB의 파티셔닝 기능이 아니라 애플리케이션 레벨에서 구현했고, 대상도 원본 문서가 아니라 채널당 300바이트 수준의 역정규화 데이터입니다. 그래서 원본에서는 문제였던 "정렬값이 변하면 문서가 파티션을 옮겨야 한다"는 비용이 감당할 수 있는 크기로 줄었습니다. 역정규화 컬렉션 전체는 무효화 대신 갱신으로 유지되는 write-through 캐시, 즉 영속화된 materialized view에 해당합니다. 기각의 이유였던 조건들을 설계로 제거하고 나니, 같은 아이디어가 성립하게 된 것입니다.
결과와 마무리하며
성과
| 지표 | 개선 전 | 개선 후 | 변화 |
|---|---|---|---|
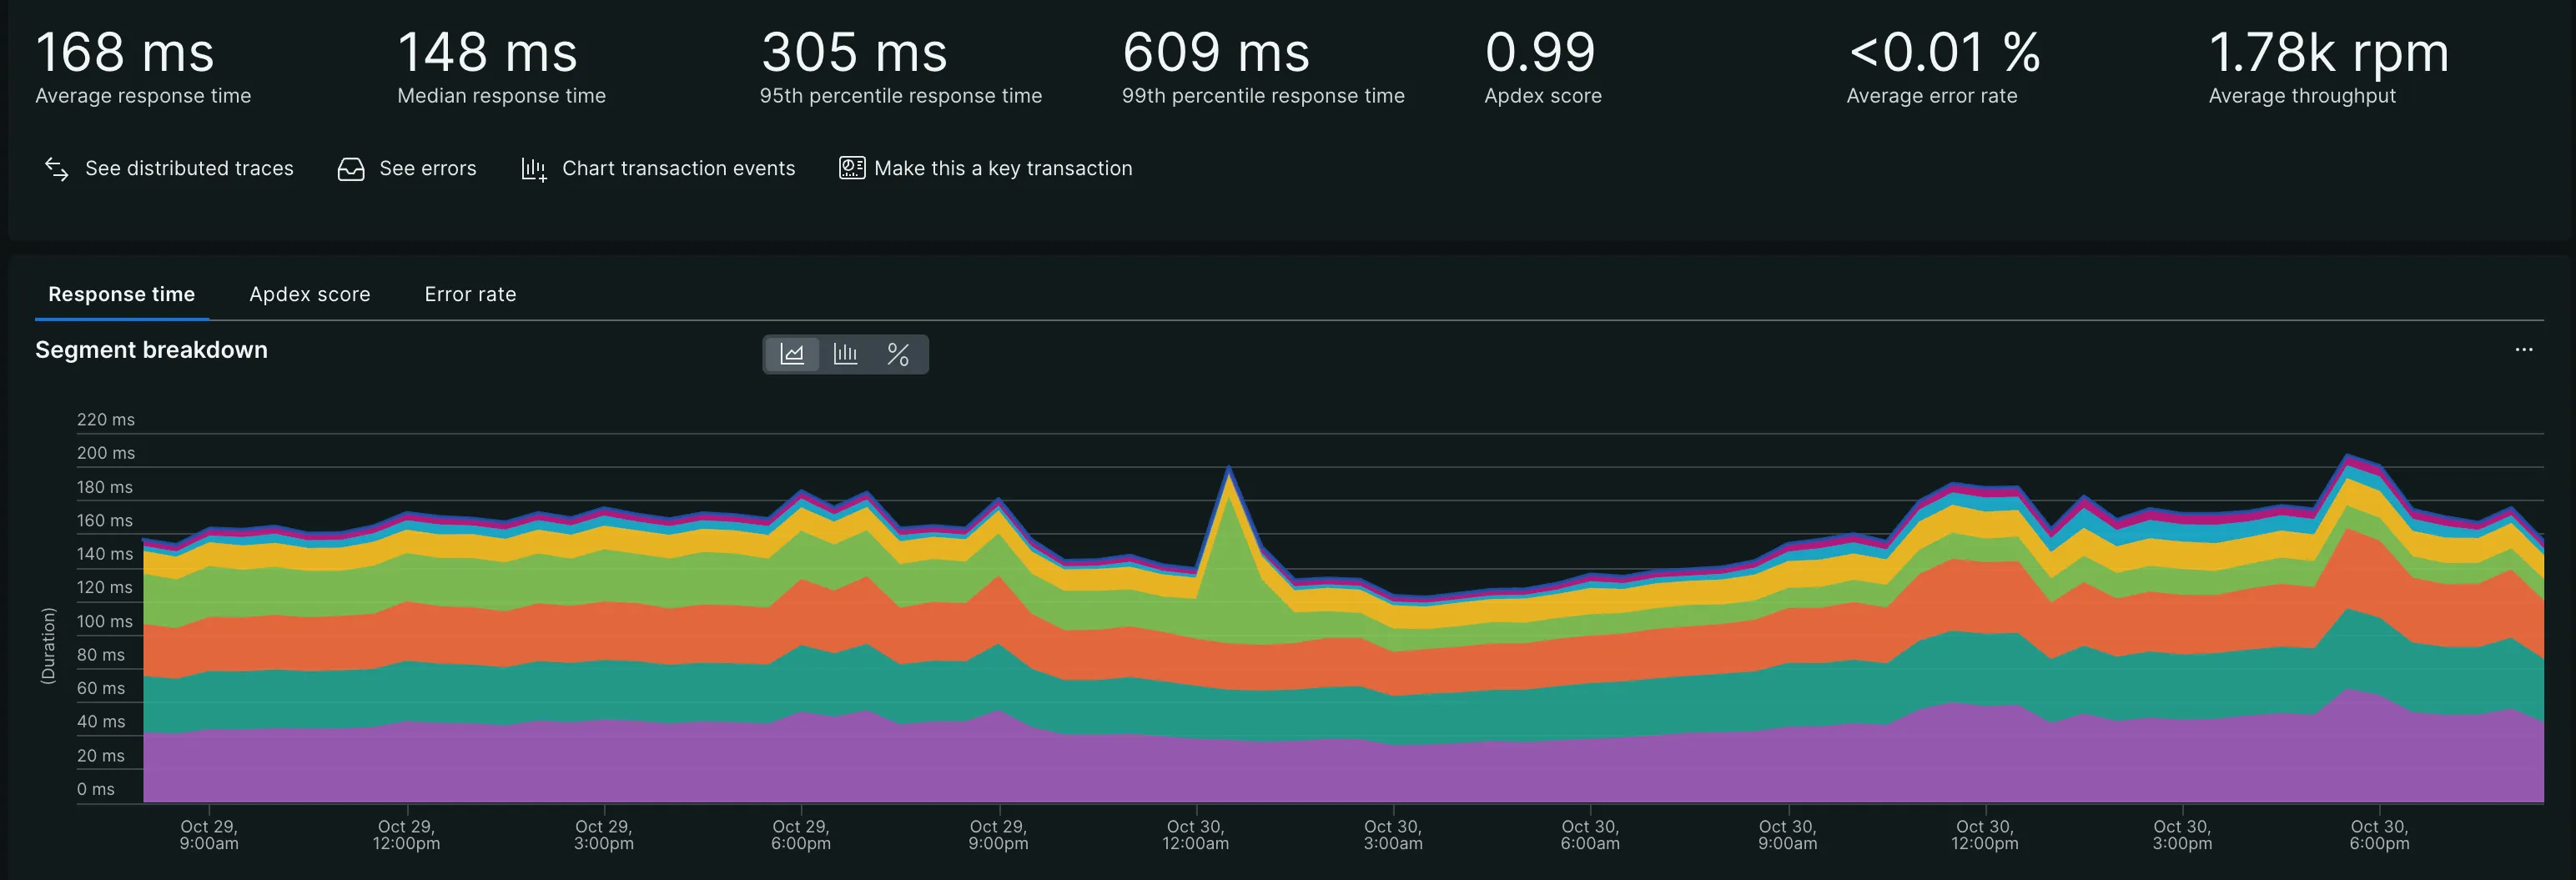
| 평균 응답 시간 | 472 ms | 155 ms | -67% |
| 95th percentile | 1.91 s | 273 ms | -86% |
| 99th percentile | 5.88 s | 578 ms | -90% |
| 5초 이상 응답 | 250건 | 13건 | -95% |
| Apdex | 0.9 | 0.99 | +10% |
- 채널 3만 개 이상 고수의 목록 진입 : 11초 → 1.8초 (범위 제한 없음 — 10년치 전체 대상)
- 키워드 검색(이름/서비스/지역) : 20~39초 → 3초 이내 (구조 개선 + 1년 범위 정책의 결합)
- MongoDB aggregate가 차지하던 DB 시간 비중 : 80% → 30% 이하
- MySQL select 호출 수 40% 감소, ChatService CPU 사용률 약 15% 절감
평균(-67%)보다 p95(-86%)와 p99(-90%)의 개선 폭이 더 큽니다. 지연의 원인이 채널 수에 비례하는 구조였고 이번 개선이 그 비례를 제거했기 때문에, 채널이 많아 지연이 컸던 요청일수록 개선 폭이 큰 것입니다. 표의 수치는 특정 사용자가 아니라 전체 트래픽의 New Relic 집계입니다.

배포 후 한 고수분이 보내주신 메시지를 그대로 옮깁니다.
"숨고가 빨라져서 너무 기분이 좋습니다. 감사합니다. 일할 때 능률이 오를 것 같습니다."
마치며
이번 작업에서 얻은 것을 세 가지로 정리합니다.
첫째, 쿼리 비용이 데이터량에 선형으로 비례하고 그 원인이 데이터 구조에 있다면, 고쳐야 할 것은 실행 계획이 아니라 데이터가 저장된 형태입니다. 이번 작업에서 그 판단의 근거는 측정이었습니다. 평균과 최대의 큰 차이, 그리고 채널 수와 응답 시간의 선형 관계(R² = 0.90)가 방향을 정해 주었습니다.
둘째, 도구의 규모는 문제가 지속되는 기간에 맞췄습니다. 3주짜리 마이그레이션을 위해 Kafka 같은 메시징 인프라를 도입하는 대신 TEXT 컬럼 하나로 catch-up 큐를 구현했고, 전환이 끝난 뒤에는 상태 머신과 함께 전부 제거했습니다.
셋째, 안전장치를 둘지는 발생 확률이 아니라, 문제가 생겼을 때 되돌릴 수 있는지를 기준으로 판단했습니다. catch-up 큐가 3주 동안 기록한 변경은 8건뿐이었지만, 이 8건은 방치하면 스스로 복구되지 않고 채팅 데이터에 민감한 고수들에게 남는 문제였습니다. 이 기준으로 안전장치를 결정한 것은 지금도 옳았다고 생각합니다.
이 모든 과정은 지난 10년간 쌓인 채팅 데이터를 한 건도 지우지 않은 채 진행했습니다. 데이터를 지우면 쉬워지는 문제였지만, 고수분들에게 채팅 기록은 거래 이력이고, 이를 보존하는 것 역시 성능만큼 중요한 요구사항이었습니다.
비슷한 문제, 즉 데이터량에 비례해 느려지고 인덱스로는 해결되지 않는 쿼리를 마주한 분들께 이 기록이 도움이 되길 바랍니다. 읽어주셔서 감사합니다.
- #backend
- #chatting
- #elastic search
- #migration
- #soomgo