우리 팀은 더 이상 코드를 손으로 짜지 않습니다
숨고 Backend 팀은 AI 코딩 어시스턴트를 각자 쓰는 대신, 팀의 개발 노하우를 실행 가능한 ‘스킬’로 만들어 공유합니다.
설계 문서 작성부터 배포 점검까지 8단계 파이프라인이 자연어 한마디로 돌아가고, 이제 기획 문서 하나로 PR까지 자율 완주하는 오토파일럿도 붙었습니다. 사람은 설계와 판단에 집중합니다.
핵심은 자동화가 아니라 복리입니다. 누구나 PR로 스킬을 고칠 수 있고, 한 사람의 개선이 그대로 팀 전체의 기본기가 되니까요. (6개월 · 536 커밋 · 13명 기여 · 스킬 29개)
금요일 오후, 같은 일을 다섯 번째 하고 있었다
새 기능 하나를 세상에 내보내는 길은 생각보다 길고, 대부분이 ‘매번 똑같은데 매번 손이 가는’ 일입니다. PRD(Product Requirements Document)를 읽고, 왜 이렇게 만들기로 했는지 결정과 근거를 남기는 설계 문서 ADR(Architecture Decision Record)을 같은 포맷으로 정리하고, PR 본문을 규칙에 맞게 채우고, 리뷰 체크리스트를 훑어본 다음 배포 전 매니페스트를 대조합니다. 문제는 이 반복이 사람마다, 그리고 같은 사람이라도 그날의 컨디션마다 품질이 달라진다는 데 있습니다.
그래서 팀에는 늘 두 종류의 지식이 따로 놉니다. 하나는 위키에 적힌 "이렇게 하세요"라는 문서, 다른 하나는 시니어의 머릿속에만 있는 "이럴 땐 이렇게 봐야 해"라는 감각. 문서는 실행되지 않아서 자주 잊히고, 감각은 공유되지 않아서 사람이 바뀌면 사라집니다.
숨고 Backend 팀이 던진 질문은 단순했습니다. 이 노하우를 문서가 아니라 ‘실행되는 무언가’로 만들 수는 없을까? 여기서 한 걸음 더 나아가고 싶었습니다. 그걸 특정 개인이 아니라, 팀 전체가 함께 키우는 자산으로 만들 수는 없을까? 이 글은 그 6개월의 이야기입니다. 결론을 먼저 살짝 말하면, 좋은 도구는 잘 만드는 것보다 함께 키우는 게 더 중요했습니다.
하루가 스킬 위에서 돌아간다
개발 라이프사이클의 각 단계마다 대응하는 스킬이 있습니다. 설계·구현·PR·리뷰·배포까지, 자연어 한마디("리뷰해줘")나 슬래시 커맨드(/soomgo-review)면 트리거됩니다. 반복 작업은 스킬이 맡고, 사람은 판단에 집중합니다.
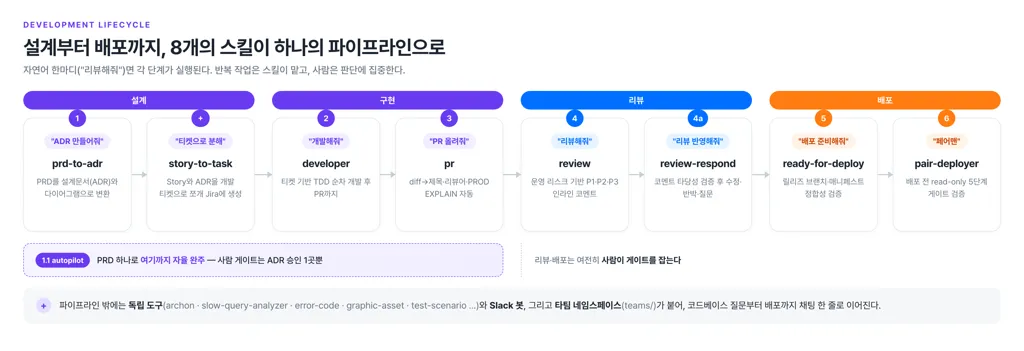
스킬은 거창한 플랫폼이 아닙니다. 각 스킬은 AI가 읽는 SKILL.md 한 장이 중심이고, 여기에 ‘무엇을·언제 한다’가 적혀 있습니다. AI 어시스턴트는 트리거 문장을 만나면 해당 SKILL.md를 읽고 그 워크플로우를 따릅니다. 예를 들어 PR을 올리는 순간은 이렇게 흘러갑니다.
"PR 올려줘"
  → git diff 분석으로 제목·본문 초안 생성
  → ORM 쿼리를 SQL로 바꿔 PROD DB에 EXPLAIN까지 실행 (느린 쿼리 사전 차단)
  → reviewer-pool에서 리뷰어 자동 선정
  → PR 템플릿에 맞춰 최종 본문 작성
이 흐름을 보면, 사람이 키보드로 코드를 직접 타이핑하는 구간은 점점 사라지고 있습니다. 설계(prd-to-adr)로 ‘무엇을·왜’를 정하면, 구현(developer)은 에이전트가 TDD 사이클(Red→Green→Refactor)로 코드를 작성합니다. 사람의 일이 타이핑에서 판단으로 옮겨간 거죠. (이 방향의 끝은 뒤에서 다시 다룹니다.)
그리고 최근에는 그 사이에 남아 있던 사람 게이트마저 줄었습니다. story-to-task가 Story와 ADR을 읽어 개발 티켓으로 쪼개 Jira에 올리고, autopilot은 PRD 링크 하나만 받아 ADR 작성 → 티켓 생성 → TDD 개발 → PR까지 한 번에 완주합니다. 사람이 멈춰 세우는 지점은 ADR 승인 딱 한 곳이고, 나머지 게이트는 자동 검증 에이전트가 대신합니다. 그 한 곳은 말로만 남겨두지 않았습니다. ADR 문서 제목의 상태 표시가 ‘작업 중’에서 ‘승인 완료’로 바뀌기 전에는 개발 스킬이 아예 진입하지 않고, 한 번에 완주하기엔 덩치가 큰 PRD는 오토파일럿이 스스로 규모를 재어 ADR까지만 만든 뒤 나머지는 사람에게 넘깁니다.
파이프라인 밖에도 손이 자주 가는 일마다 스킬이 있습니다. archon은 40여 개로 쪼개진 서비스의 테이블·API·서비스 간 호출 관계를 미리 인덱싱해 "이 테이블 누가 쓰지?"에 코드 근거로 답하고, slow-query-analyzer는 슬로우 쿼리 알림 하나를 받아 EXPLAIN과 코드 추적까지 마친 뒤 수정 PR을 올립니다. (이 글에 들어간 그림들 역시 graphic-asset이라는 스킬로 그렸습니다.)
그리고 이 모든 걸 쓰려고 굳이 터미널을 열 필요도 없습니다. Slack 스레드에서 @backend-bot /review 한 줄이면 broker가 알아서 해당 스킬로 라우팅하고, 결과를 다시 스레드로 돌려줍니다. 리뷰뿐 아니라 리뷰 반영, 배포 점검, 위클리 노트까지 같은 방식으로 붙어 있습니다. 코드베이스 질문부터 배포 점검까지, 대화창 한 줄로 이어지는 셈입니다.
이 판은 이제 Backend 팀 밖으로도 열렸습니다. teams/ 네임스페이스가 생기면서 데이터팀이 자기 스킬(tracker-flow)을 같은 레포에 올렸습니다. 소유와 리뷰는 각 팀이 가져가되, archon 같은 공용 인프라는 그대로 재사용합니다. 한 팀이 다듬어 둔 작성 표준이 다른 팀의 출발선이 됐습니다.
지금 팀이 함께 쓰는 스킬은 29개입니다. 하나하나가 궁금하시면 맨 뒤 부록에 전체 목록을 정리해 뒀습니다.
비유하자면 — 스킬은 밑반찬과 같습니다. 손님이 올 때마다(=매 작업마다) 처음부터 요리하는 게 아니라, 미리 만들어 둔 표준 반찬을 꺼내 상을 차립니다. 요리사(사람)는 그날의 메인 요리, 즉 진짜 판단이 필요한 곳에만 집중하면 됩니다.
그래서, 실제로 이렇게 나옵니다
"자동화라지만 품질이 나오겠어?" 자연스러운 의심입니다. 그래서 기능 하나(견적 발송)가 문서 → 코드 → 리뷰를 거치며 어떤 산출물을 만들어 내는지 그대로 보여드립니다.
아래 세 가지(ADR·코드·리뷰) 예시는 특정 PR이나 문서를 그대로 캡처한 것이 아니라, 팀이 실제로 쓰는 포맷과 실제로 나왔던 사례를 바탕으로 재구성한 대표 예시입니다. 보안·프라이버시를 위해 내부 코드·데이터는 일반화했지만, 포맷과 판정 기준(P1/P2/P3, 검증 섹션, ADR 섹션 구성 등)은 실제 그대로입니다.
① 문서 - PRD가 설계 문서(ADR)가 되는 과정
prd-to-adr는 PRD를 읽고 대화형으로 ADR을 채웁니다. 배경·결정·고려한 대안·영향을 정리하고, 시퀀스 다이어그램은 Mermaid로, ERD와 아키텍처 다이어그램은 draw.io로 그려 Confluence에 올립니다. 아래가 실제로 만들어지는 ADR 문서의 모습입니다.
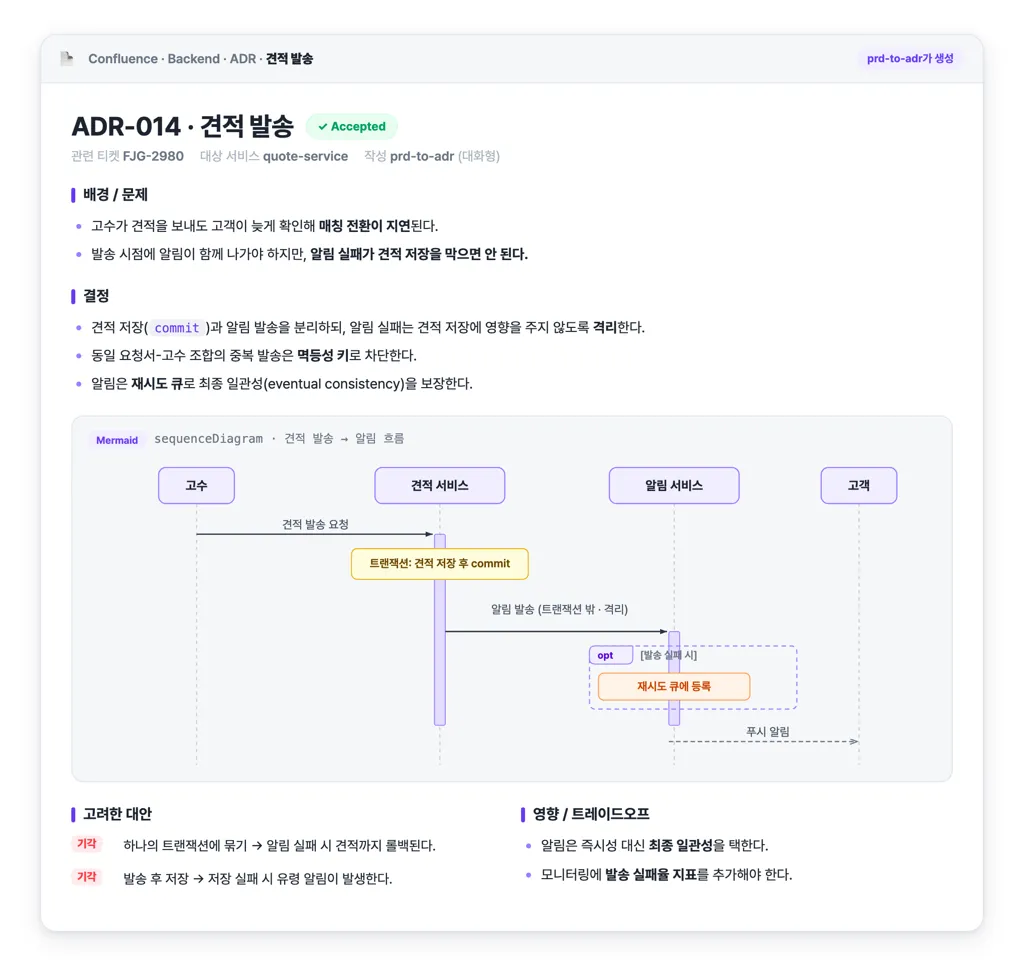
중요한 건 한 번에 완성본을 내놓지 않는다는 점입니다. 섹션 하나씩 초안을 보여주고, 피드백을 받아 고친 뒤 다음 섹션으로 넘어갑니다. 그래서 설계 의도가 사람 손을 떠나지 않습니다. 왜 트랜잭션을 이렇게 나눴는지와 어떤 대안을 왜 기각했는지까지 기록되니, 나중에 읽어도 근거가 살아 있는 문서가 됩니다.
② 코드 - 테스트를 먼저 쓰고, 리뷰 기준을 구현 단계에서 미리 반영
developer는 테스트를 먼저 씁니다. 실패하는 테스트를 쓰고(RED), 통과하는 최소 코드를 쓰고(GREEN), 정리합니다(REFACTOR). GREEN 단계에서 리뷰 기준(트랜잭션 범위·외부 호출 격리·동시성과 멱등성·N+1·빈값 처리)을 미리 적용해, 리뷰에서 지적당할 코드를 처음부터 줄입니다.
‘견적 발송’ 기능 하나가 이렇게 여러 번의 사이클로 쪼개집니다.
RED  test_견적_발송_성공              → GREEN 최소 구현              → REFACTOR
RED  test_필수값_누락시_400           → GREEN 입력 검증 추가         → REFACTOR
RED  test_중복_발송_방지              → GREEN 멱등성 키 추가         → REFACTOR
RED  test_알림_발송_실패시_견적은_유지 → GREEN try/except + 재시도 큐 → REFACTOR
실제 테스트 코드는 이렇게 생겼습니다.
# app/tests/v1/test_quote_send.py
class TestQuoteSend:
    # 견적 발송 - HTTP + 비즈니스 규칙 검증

    def test_견적_발송_성공(self, client):
        response = client.simulate_post('/v1/quotes/send',
                                        json={'request_id': 1, 'pro_id': 10})
        assert response.status == '200 OK'
        assert response.json['code'] == 0

    def test_중복_발송_방지(self):
        service = QuoteSendService()
        service.send(request_id=1, pro_id=10)
        # 같은 요청서-고수 조합은 두 번 발송되지 않는다
        with pytest.raises(AlreadySentError):
            service.send(request_id=1, pro_id=10)

    def test_알림_발송_실패시_견적은_유지(self, mocker):
        mocker.patch.object(notification_client, 'send_push',
                            side_effect=TimeoutError)
        service = QuoteSendService()
        quote = service.send(request_id=2, pro_id=10)
        # 알림이 실패해도 견적 저장은 롤백되지 않는다
        assert Quote.get(quote.id) is not None
테스트가 실패하는 것을 먼저 확인한 뒤에야 구현을 씁니다. 새로 짠 코드의 커버리지 100%(분기 포함)를 목표로, 정상 흐름 · 입력 검증 · 엣지케이스 · 외부 호출 실패까지 빠짐없이 덮습니다.
③ 리뷰 - PR에 이렇게 달립니다
review는 코드 스타일을 제외한 보안·안정성·정확성·호환성·테스트, 다섯 가지 관점으로만 봅니다. 운영 리스크 순으로 시급한 순으로 왼쪽부터 P1·P2·P3 등급을 매기고, 각 지적을 해당 코드 줄에 인라인 코멘트로 답니다. 아래가 PR에 실제로 게시되는 모습입니다.
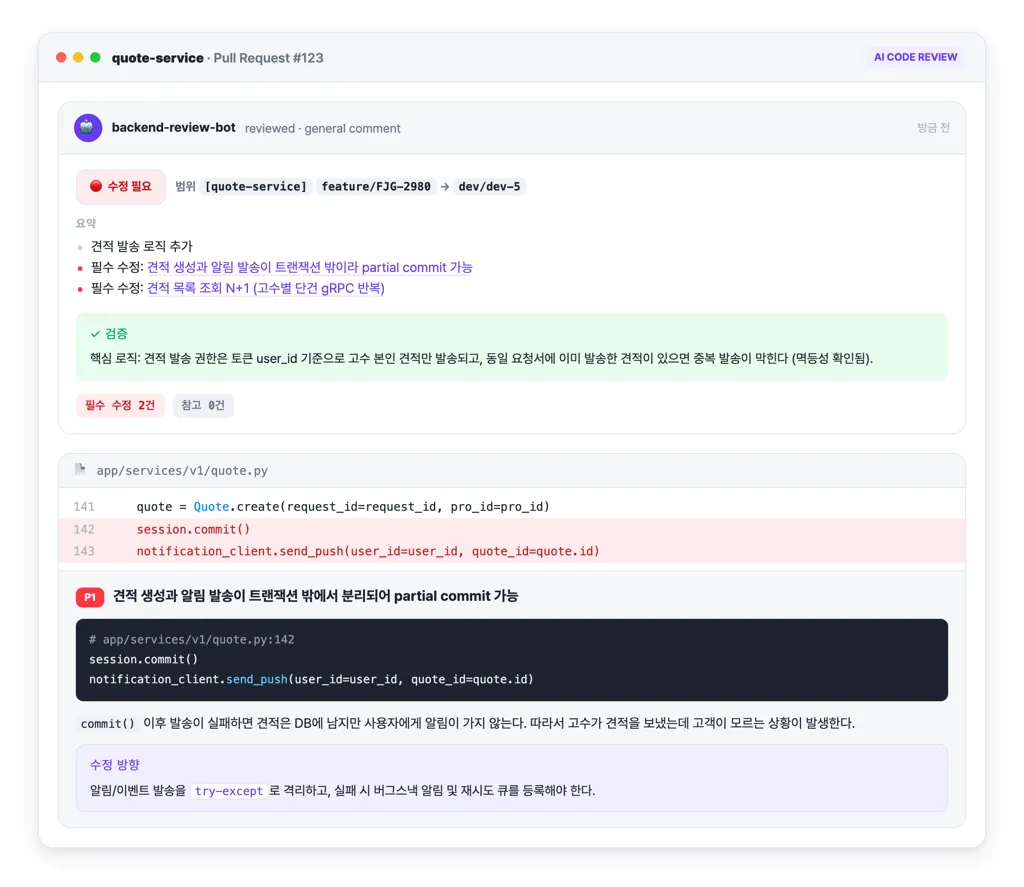
여기서 주목할 두 가지가 있습니다.
- 첫째, 리뷰는 형식적인 확인 절차가 아닙니다. 이 예시에서는 ‘커밋 이후 알림 발송이 실패하면 견적은 DB에 남지만 알림만 누락되는’ partial commit 위험(P1)을 잡아냈습니다. 앞 단계에서 아무리 잘 짜도, 독립적인 리뷰가 놓친 리스크를 다시 걸러냅니다
- 둘째,
검증섹션에 무엇을 트레이싱해 정상으로 확인했는지를 남깁니다. ‘문제 없음’ 같은 빈 문구는 금지하고, 실제로 확인한 대상만 적게 합니다. 무엇을 보고 통과시켰는지가 남아야 그 판단을 다음 사람이 믿을 수 있고, 리뷰가 팀의 자산으로 쌓입니다
그리고 이 리뷰는 독립된 컨텍스트의 2차 리뷰로 한 번 더 교차 검증됩니다. 한 번의 리뷰가 놓친 부분을, 다른 컨텍스트의 리뷰가 잡습니다. 리뷰는 한 번 달고 끝나지도 않습니다. 같은 PR에서 다시 돌리면 앞서 단 지적과 거기 달린 작성자의 답글을 먼저 읽어 이미 해결된 것은 빼고, 코드를 고쳐 다시 푸시하면 새로 올라온 커밋만 봅니다. 같은 지적이 두 번 쌓이지 않습니다.
진짜 이야기는 '쓰는 법'이 아니라 '고치는 법'이다
스킬이 인상적인 이유는 따로 있습니다. 누구나 스킬을 고칠 수 있고, 그 개선이 곧바로 팀 전체로 퍼진다는 점입니다. 스킬은 완성품이 아니라, 팀이 매일 다듬는 살아있는 자산입니다.
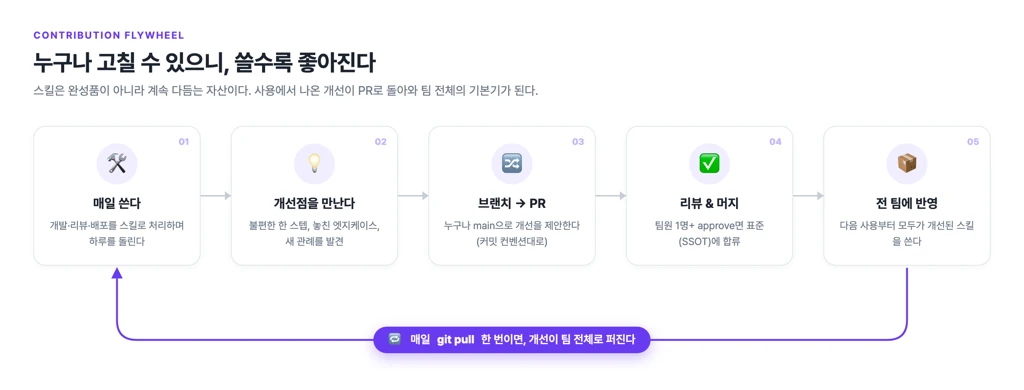
흐름은 GitHub의 여느 오픈소스와 똑같습니다. 스킬을 쓰다가 불편한 스텝, 놓친 엣지 케이스, 새로 생긴 관례를 발견하면 브랜치를 따고, 커밋 컨벤션(feat:, fix:, docs:)에 맞춰 main으로 PR을 올립니다. 팀원 한 명 이상의 approve를 받으면 머지되고, 다른 팀원들은 git pull 한 번으로 개선된 스킬을 그날부터 함께 씁니다. 내 불편함 하나가, 팀 전체의 다음 작업을 더 낫게 만드는 구조입니다.
이 선순환이 혼돈으로 흐르지 않고 자산으로 쌓이도록, 세 가지 장치를 뒀습니다.
- 단일 작성 표준(SSOT) -
docs/skill-authoring.md가 모든 스킬의 구조와 문체를 규정합니다. 본문은 "무엇을·언제"만 담고, 상세 룰·예시는references/로 분리하며, 판정·분기는 산문 대신 표로 씁니다. 덕분에 누가 기여해도 스킬의 결이 흐트러지지 않습니다 - 사람과 AI를 위한 문서의 분리 - AI가 읽는
SKILL.md와 사람이 읽는README.md가 나뉘고, 루트 카탈로그와 팀 위키(Confluence)는 자동으로 동기화됩니다. 최근에는 스킬마다 에이전트 진입점(agents/)까지 정비되어, 원격에서 도는 자동화의 뼈대가 되었습니다 - 팀의 코드 컨벤션도 같은 레포에서 - 아키텍처·네이밍·테스트·DB·시간대 같은 Backend 공통 규약을
conventions/에 SSOT로 두고, 개발·리뷰·설계 스킬이 그때그때 필요한 문서만 읽어 갑니다. 규칙 한 줄을 고치면 그 규칙을 읽는 스킬들의 판단이 함께 바뀝니다
그리고 이 모든 게 가능했던 건, 누군가 맨 처음에 씨앗을 심고 울타리를 세워 뒀기 때문입니다. 첫 커밋으로 레포의 뼈대를 잡고, 작성 표준과 리뷰 규칙(1명 이상 approve, 커밋 컨벤션, 카탈로그 등록)을 함께 정해 둔 것. 그 위에서라면 누구든 안심하고 손을 댈 수 있습니다. 자기가 다 만드는 대신 남들이 기여할 수 있는 판을 깔아 둔 셈입니다.
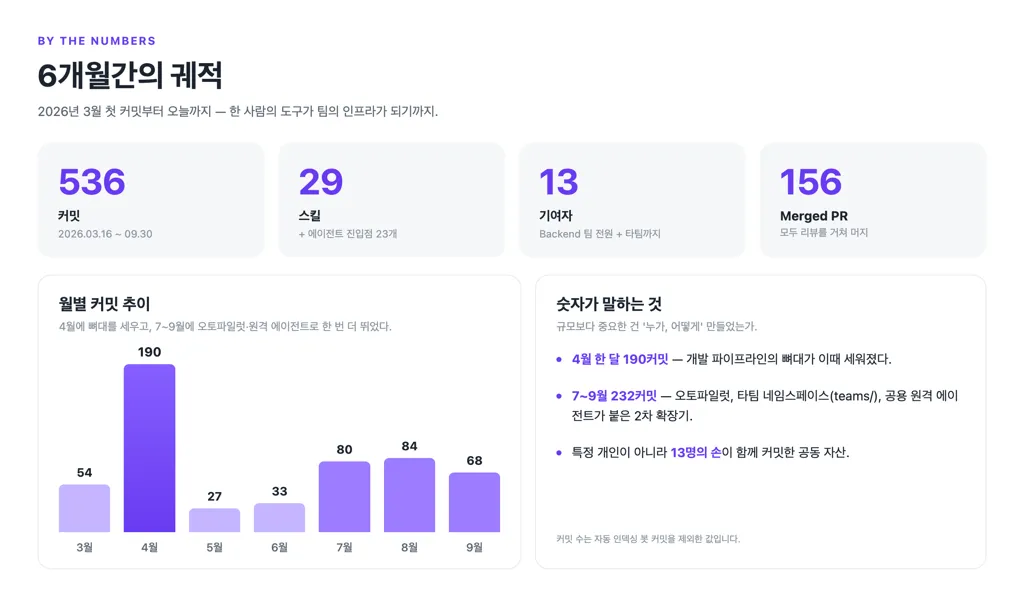
숫자가 이 문화를 증명합니다. 6개월 동안 536개의 커밋, 156개의 머지된 PR, 그리고 13명의 엔지니어가 손을 보탰습니다. 특히 4월 한 달에 190개의 커밋이 쏟아지며 파이프라인의 뼈대가 세워졌고, 잠잠하던 5-6월을 지나 7-9월에 다시 232개의 커밋이 몰리며 오토파일럿·타팀 네임스페이스·에이전트 진입점·공용 원격 에이전트가 붙었습니다. 폭발적으로 만들어 내는 시기와 다듬어 표준으로 굳히는 시기가 번갈아 이어졌습니다.
만들다 지쳐 방치된 사이드 프로젝트가 아니라, 팀 전원이 함께 관리하는 공동 인프라라는 뜻입니다. 보통의 팀 위키가 열어봐야 읽히는 지식이라면, 스킬은 매 작업마다 자동으로 소환되는 지식입니다. 그래서 갱신할 이유도, 갱신의 보람도 훨씬 큽니다.
기여 흐름은 이렇습니다.
# 1. 최신 main에서 브랜치 생성
git checkout main && git pull origin main
git checkout -b feature/improve-review

# 2. skills/{skill-name}/ 내 파일 수정 (SKILL.md / README.md / references ...)

# 3. 커밋 컨벤션에 맞춰 PR
git commit -m "feat: review - P2 판정 기준에 미등록 에러코드 추가"
git push origin feature/improve-review
# → GitHub에서 main으로 PR, 팀원 1명+ approve 후 머지
새 스킬 추가 시 체크리스트: SKILL.md(작성 표준 준수) → README.md → 루트 카탈로그 표 등록 → agents 진입점 생성 → 리뷰 요청. 같은 설명을 카탈로그와 상세에 중복하지 않고, 트리거 표기는 setup.sh와 일치시킵니다.
각자 노트북에서 돌리던 걸, 팀 공용으로 옮겼다
지금까지의 그림에는 숨은 전제가 하나 있었습니다. 각자 자기 노트북에 설치해서 쓴다는 것이죠. 시작은 쉽지만, 팀 규모로 가면 곳곳에서 삐걱댑니다.
- 설치·토큰·설정이 사람마다 - MCP 연결, 토큰, 셋업이 조금씩 달라 "나는 되는데 너는 안 됨"이 반복됩니다
- 버전이 제각각 - 최신 상태는 각자 git pull로 맞춰야 해서, 안 당긴 사람은 옛 스킬을 쓰고 있습니다
- 항상 켜져 있지 않음 - 스킬이 내 노트북에서만 도니, 팀 공용으로 24시간 자동 실행할 수 없습니다
- 리뷰 결과가 갈림 - 같은 PR이라도 누가 돌리느냐에 따라 AI 리뷰 결과가 달라집니다 (역설적으로, 이 차이가 사실상 교차 검증 역할을 하고 있었습니다)
그래서 팀은 스킬이 도는 자리를 옮겼습니다. 개인 노트북이 아니라 팀이 공유하는 원격 에이전트가 대신 실행하게 만드는 방향입니다.
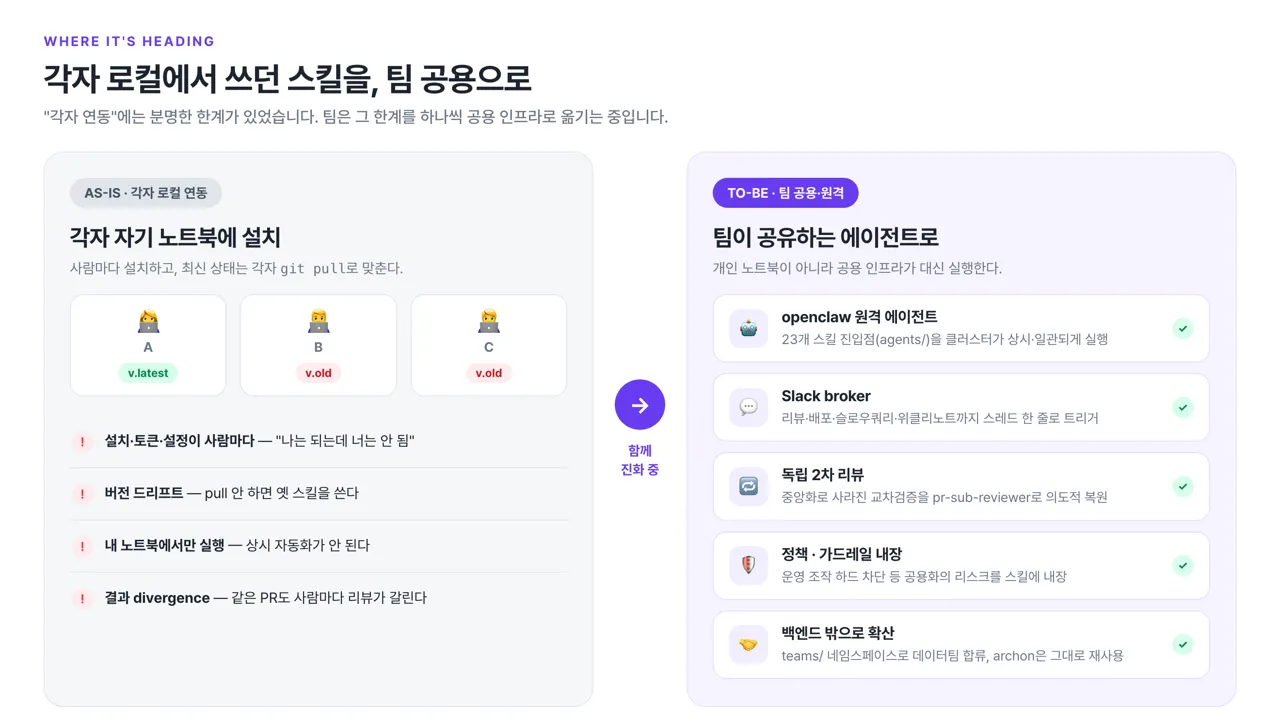
대표적인 예가 **PR 리뷰 에이전트(pr-reviewer)**입니다. 개인이 각자 리뷰를 돌리는 대신, openclaw 클러스터에서 도는 공용 에이전트가 리뷰 요청을 받아 review·archon·error-code-manager 같은 스킬을 스스로 엮어 리뷰합니다. 로컬에 레포가 없어도 API로 diff를 받고 필요한 레포를 그때그때 clone해 영향 범위까지 추적합니다. 누구 노트북이 켜져 있든 상관없이, 일관된 품질로, 상시 동작합니다. Backend 스킬만 이렇게 도는 것도 아닙니다. 데이터팀의 tracker-flow도 같은 클러스터에서 에이전트로 돌아갑니다 — 방법론은 데이터팀이 소유하고, 에이전트에 태워 상시 돌리는 운영은 Backend가 맡는 식으로 역할만 나눴습니다.
가장 눈여겨볼 건 팀이 한계를 그냥 감수하지 않았다는 점입니다. 리뷰를 중앙 에이전트 한 곳으로 모으자, 앞서 말한 사람마다 리뷰 결과가 갈리던 것(=우연한 교차 검증)이라는 안전망이 사라졌습니다. 그래서 팀은 그 안전망을 의도적으로 다시 설계했습니다. PR 첫 리뷰에 한해, 독립된 컨텍스트의 2차 리뷰 에이전트를 한 번 더 돌려 두 결과를 교차 검증한 뒤 하나로 합쳐 게시합니다. 한계를 그대로 두지 않고, 더 나은 구조로 보완한 것입니다.
여기에 공용화의 리스크를 관리하는 가드레일(위험한 작업을 실행 전에 막아 두는 안전장치)도 함께 세웠습니다. 운영 환경을 직접 건드리는 명령은 실행되기 전에 차단하고, 사람이 승인한 점검 건만 통과시킵니다. 그리고 중요한 건, 이 진화 역시 특정 개인이 아니라 팀이 함께 PR로 만들어 왔다는 사실입니다. broker도, agents 진입점도, 2차 리뷰도, 가드레일도, 타팀 네임스페이스도, 모두 누군가의 ‘이게 불편한데?’에서 시작된 기여였습니다.
물론 공유 자산이면 늘 따라오는 그림자도 있습니다. 모두가 같은 스킬을 쓰는 만큼 잘못된 스킬은 잘못도 빠르게 전파하고, 코드베이스가 바뀌면 스킬에도 유지보수 비용이 듭니다. 완벽한 시스템이라 소개하는 게 아닙니다. 오히려 이 한계들을 팀이 대화의 소재로 꺼내 함께 관리한다는 점이 핵심입니다.
스킬의 진짜 힘은 '복리'였다
처음의 질문으로 돌아갑니다. AI 코딩 도구, 각자 알아서 쓰면 되는 거 아닌가요? 각자 쓰면 그날의 생산성은 오릅니다. 하지만 그 노하우는 그 사람의 채팅창에만 남고, 내일이면 옆자리 동료가 같은 시행착오를 반복합니다.
스킬을 공유 자산으로 만들면 이야기가 달라집니다. 한 사람이 발견한 더 나은 방법이 PR로 돌아와 팀 전체의 기본기가 되고, 그렇게 매일 조금씩 쌓입니다. AI 스킬의 진짜 힘은 자동화가 아니라 복리에 있었습니다. 쓸수록 좋아지고, 고칠수록 팀 전체가 함께 좋아지니까요.
| 각자 쓰는 프롬프트 | 팀이 키우는 스킬 | |
|---|---|---|
| 지식의 위치 | 개인의 채팅창 | 버전 관리되는 공동 레포 |
| 품질 | 사람·컨디션마다 편차 | 표준(SSOT)과 2차 검증으로 고르게 |
| 개선의 전파 | 공유되지 않음 | PR 한 번 → 전 팀 즉시 반영 |
| 실행 위치 | 내 노트북에서만 | 내 노트북에서도, 공용 원격 에이전트에서도 |
| 사람의 역할 | 직접 코드를 타이핑 | 방향을 정하고 판단 |
| 시간이 지나면 | 매번 처음부터 | 복리로 축적 |
이 6개월이 우리에게 남긴 것은 스킬 29개가 아니라, 세 가지 배움이었습니다.
- 노하우는 실행될 때 살아남습니다. 읽는 문서는 잊히지만, 매 작업에 소환되는 지식은 팀의 근육이 됩니다
- 큰 변화도 결국 PR 한 번에서 시작됐습니다. 개인의 작은 개선이 팀의 기본기로 바뀌고, 그게 매일 쌓입니다
- 도구는 사람을 대체하지 않고, 더 중요한 판단에 집중하게 해줬습니다. 설계로 "무엇을·왜"를 정하면 구현은 에이전트가 쓰고, 리뷰도 배포 점검도 에이전트가 먼저 돌립니다. 타이핑은 넘기고, 사람은 방향을 정하는 자리에 섭니다
숨고 Backend 팀은 오늘도 그 자산을 한 줄의 PR로 함께 키우고 있습니다.
부록: 스킬 전체 목록
본문에 다 담지 못한 29개 스킬의 전체 목록입니다. 궁금한 것만 골라 보셔도 됩니다.
개발 파이프라인 — 설계부터 배포 점검까지 순서대로 이어지는 스킬입니다.
| 스킬 | 하는 일 |
|---|---|
| prd-to-adr | PRD를 ADR로 대화형 변환, 시퀀스·ERD·아키텍처 다이어그램 + Confluence 업로드 |
| autopilot | PRD 하나로 ADR→개발→PR까지 자율 완주, 사람 게이트는 ADR 승인 1곳 |
| story-to-task | Story와 ADR을 읽어 개발 티켓으로 분해해 Jira에 등록 |
| developer | ADR·티켓 기반 TDD 순차 개발 후 PR 생성 |
| pr | diff 분석으로 PR 제목·본문·리뷰어 생성, ORM→SQL PROD EXPLAIN 포함 |
| review | 운영 리스크 기반 코드리뷰(P1/P2/P3), PR 인라인 코멘트 게시 |
| review-respond | 리뷰 코멘트 검증 후 수정·반박·질문 + PR 답글 |
| ready-for-deploy | release 브랜치 생성, config·manifest 정합성 점검, manifest PR, Slack 인벤토리 |
| pair-deployer | 읽기 전용 배포 검증 (Phase 0~4 게이트) |
독립 도구 — 워크플로우와 무관하게 필요할 때 단독으로 호출합니다.
| 스킬 | 하는 일 |
|---|---|
| archon | 40여 개 서비스의 테이블·API·gRPC·태스크 인덱스로 코드베이스 질문에 근거와 함께 답변 |
| error-code-manager | 에러코드 발급·조회, Confluence를 SSOT로 두고 동시 발급 충돌 방지 |
| slow-query-analyzer | 슬로우 쿼리 알림 1건 → fingerprint·EXPLAIN·코드 추적·진단 리포트 후 수정 PR |
| request-call-checker | 트래픽 vs 코드 엔드포인트 비교로 미사용 API 식별 |
| graphic-asset | 디자인 시스템 토큰 기반 그래픽 에셋(HTML+CSS → 2x PNG) 생성 |
| test-scenario | QA 시나리오·기획서를 코드 트레이싱으로 PASS/FAIL 검증 |
| functional-test | task·에픽 단위 기능 테스트를 라이브 서버 + curl로 작성·실행, 전 task 완료 후 통합 플로우 도출 |
| backend-pr-bot | OPEN PR의 미승인 리뷰어를 Slack으로 자동 멘션 |
| pr-simple | pr 스킬의 간소화 버전(EXPLAIN·lint·test 생략), 명시 호출 전용 |
| weekly-note · tech-weekly | 주간 업무를 수집해 위클리 노트·미팅노트를 담당자별로 갱신 |
| chapter-schedule | 위클리 노트를 소스로 챕터 전원의 개인별 프로젝트 일정(간트)을 주간 갱신 |
| onboarding-setup | 신규 입사자의 macOS 로컬 개발 환경 멱등 세팅 |
Slack 연동 — slack-backend-bot broker가 스레드 메시지를 해당 스킬로 라우팅하고 결과를 돌려줍니다.
| 스킬 | 하는 일 |
|---|---|
| slack-backend-bot | Slack ↔ Claude Code 범용 브릿지(broker). 스레드에서 스킬 실행·결과 수신 |
| slack-review | 코드리뷰를 Slack용으로 래핑 (스레드 요약 / DM 상세) |
| slack-review-respond | 리뷰 반영을 Slack 스레드에서 트리거 |
| slack-pair-deployer | 배포 검증을 버튼·phase gate 인터랙션으로 |
| slack-bugsnag-ops | Bugsnag 에러 조사 후 3-버튼으로 수정·PR·보류 선택 |
| slack-weekly-note | 위클리 노트를 Slack에서 트리거, 즉시 반영 |
타팀 스킬 — Backend가 아닌 팀이 소유하는 스킬은 teams/ 네임스페이스에서 관리합니다. 폴더와 CODEOWNERS로 소유만 갈라지고 archon 같은 공용 인프라는 그대로 재사용합니다.
| 팀 | 스킬 | 하는 일 |
|---|---|---|
| 데이터팀 | tracker-flow | APP·WEB 코드에서 이벤트 트래커의 실제 호출명·발생 시점·수집 프로퍼티를 전수 추적 |
- #agile
- #ai
- #artificial intelligence
- #automation
- #backend