글자 너머의 의도를 읽는 Elasticsearch 기반 하이브리드 검색
안녕하세요, 숨고 백엔드 엔지니어 Olivia입니다.
숨고에서 사용자가 가장 먼저 마주하는 화면은 "어떤 서비스가 필요하세요?"를 묻는 검색창입니다. 사용자가 필요한 서비스를 정확히 찾아내는 일은 곧 숨고의 첫인상이자, 고수 매칭으로 이어지는 여정의 출발점이죠.
그래서 우리는 검색이 사용자가 입력한 글자뿐 아니라, 그 안에 담긴 '의도'까지 읽어내길 바랐습니다. 이번 글에서는 기존 BM25 기반 검색에 벡터 검색을 더해 하이브리드 검색으로 전환한 과정과 그 과정에서 내린 기술적 의사결정을 소개하고자 합니다.
기존 검색의 아쉬움
숨고의 서비스 검색은 그동안 Elasticsearch의 BM25 알고리즘을 기반으로 작동했습니다. BM25는 사용자가 입력한 검색어를 토큰으로 나눈 뒤, 그 토큰들이 서비스명·키워드의 표기와 얼마나 일치하는지를 정교하게 계산해 순위를 매기는 방식으로, 오랫동안 검증된 강력한 검색 알고리즘입니다. 실제로 대부분의 검색에서 BM25는 훌륭하게 동작했습니다. ‘이사 청소’를 검색하면 이사 청소 서비스가, ‘영어 과외’를 검색하면 영어 과외 서비스가 정확히 상단에 노출됐습니다.
다만 BM25에는 태생적인 한계가 있습니다. 글자가 일치하는지는 계산할 수 있지만, 그 글자가 무슨 '의미'인지는 모른다는 점입니다. 검색어가 서비스명 표기에는 없는 다른 표현일 때 이 특성이 드러났습니다.
몇 가지 예를 볼까요?
- 고3 — 사용자의 의도는 '입시 준비'일 가능성이 높습니다. 하지만 검색 결과에는 숫자 '3'이 포함된
3D 프린팅, 3D 모델링같은 서비스가 상위에 올라오곤 했습니다. - 고양이 — 반려동물과 관련된 서비스를 기대하지만,
국내 이사가 최상단에 노출되고 있었습니다.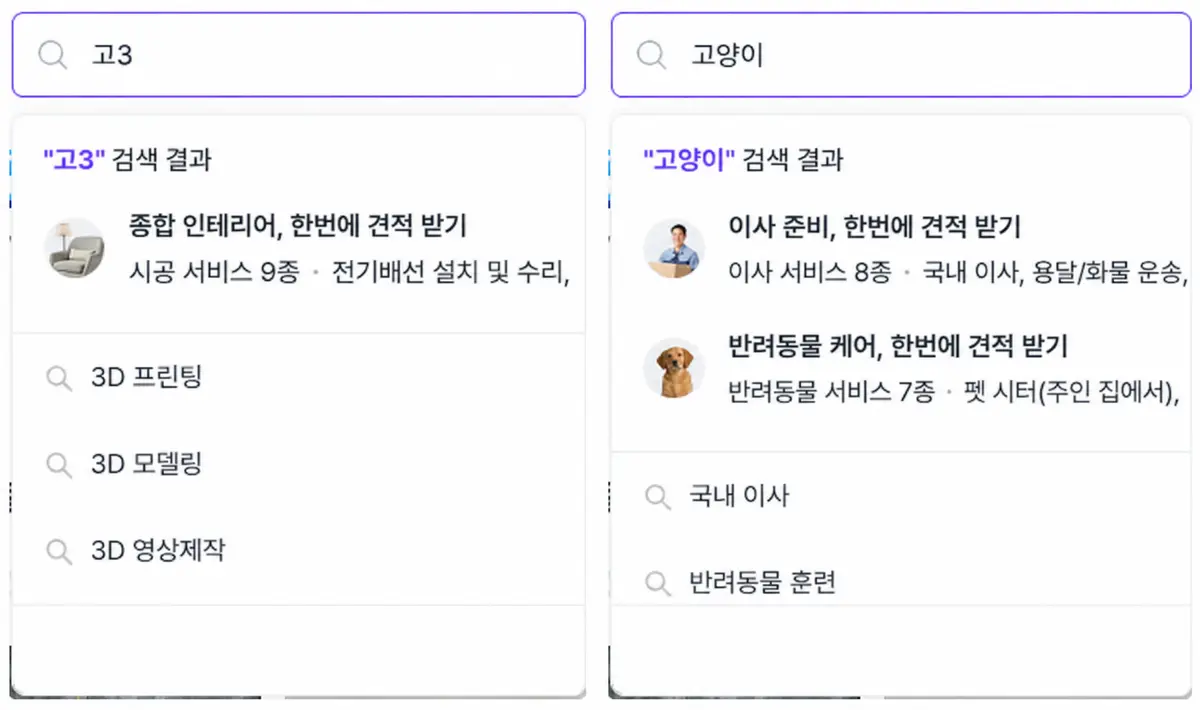
사실 기존 검색도 글자를 단순히 비교하기만 한 건 아니었습니다. 서비스명을 형태소·부분 문자열(ngram) 등 여러 방식으로 나눠 색인하고, 초성·자소 입력까지 보정하는 등 이 신호들을 가중치로 결합해 최대한 폭넓게 검색되도록 다듬어온 구조였습니다. 고3에서 '3'이 걸린 것도, 이 중 ngram 필드가 '3'을 하나의 토큰으로 잡아냈기 때문입니다.
또한 서비스명에 직접 등장하지 않는 검색어도 매칭되도록 연관 키워드(mapping_keywords)를 함께 활용하고 있었습니다. 예시의 ‘고양이’ 검색에서 국내 이사가 노출된 건, 이사 서비스의 연관 키워드에 ‘고양이 이사’가 포함되어 있어 '고양이'라는 글자에 매칭됐기 때문입니다. 반려동물과 함께 이사하는 사용자처럼 다양한 케이스를 최대한 잡아주려던 시도였죠. 검색 범위를 넓혀주는 유용한 장치였지만, 매칭 범위를 넓히는 만큼 이런 의도치 않은 매칭도 함께 따라올 수 있었습니다.
결국 문제의 본질은 하나였습니다. 검색이 글자는 보고 있지만, 의미는 보지 못한다는 것. 이 지점을 넘어서고 싶었습니다.
방향: 글자에 '의미'를 더하기
글자 매칭의 한계를 넘어서는 방법으로 우리가 주목한 것은 벡터 검색(Vector Search) 입니다.
벡터 검색은 검색어와 서비스를 각각 임베딩 모델을 통해 고차원 벡터로 변환한 뒤, 벡터 공간에서 의미적으로 얼마나 가까운지를 계산합니다. '고3'과 '입시 준비'는 글자는 전혀 겹치지 않지만 의미가 가깝기 때문에, 벡터 공간에서는 서로 가까이 위치하게 됩니다. 즉, 글자가 아닌 의미로 검색하는 방식입니다.
새로운 시도의 진입장벽을 크게 낮춰 준 배경이 있었습니다. 하나는 임베딩입니다. 숨고는 이미 AI 요청서 설계기에서 서비스 벡터와 입력어 임베딩(bi-encoder)을 활용하고 있어, 임베딩 파이프라인을 새로 만들 필요가 없었습니다. 다른 하나는 검색 엔진 그 자체입니다. 기존 검색이 올라가 있던 Elasticsearch는 벡터를 저장하는 dense_vector 필드와 kNN(최근접 이웃) 검색을 자체적으로 지원합니다. 덕분에 우리는 벡터 검색을 위한 인프라를 처음부터 만들 필요 없이, 기존 인프라를 그대로 활용해 서비스 검색에 확장 적용할 수 있었습니다.
여기서 중요한 판단이 있었습니다. 벡터 검색만으로 BM25를 완전히 대체하지는 않기로 한 것입니다.
벡터 검색은 의미 파악에 강하지만, 반대로 정확한 단어를 입력한 검색이나 짧은 키워드에서는 BM25만큼 또렷하게 정답을 짚어내지 못할 수 있습니다. 짧은 검색어일수록 담긴 맥락이 적어 의미 벡터가 흐려지기 때문입니다. 두 방식은 서로의 약점을 메워주는 관계였기에 우리는 둘을 함께 쓰는 하이브리드 검색을 택했습니다. BM25의 정확한 글자 매칭 위에, 벡터 검색의 의미 이해를 더하는 방향이었죠.
설계: 하이브리드 검색 구현하기
하이브리드 검색의 핵심은 BM25 점수와 벡터 검색 점수를 '어떻게 하나의 순위로 합칠 것인가'입니다.
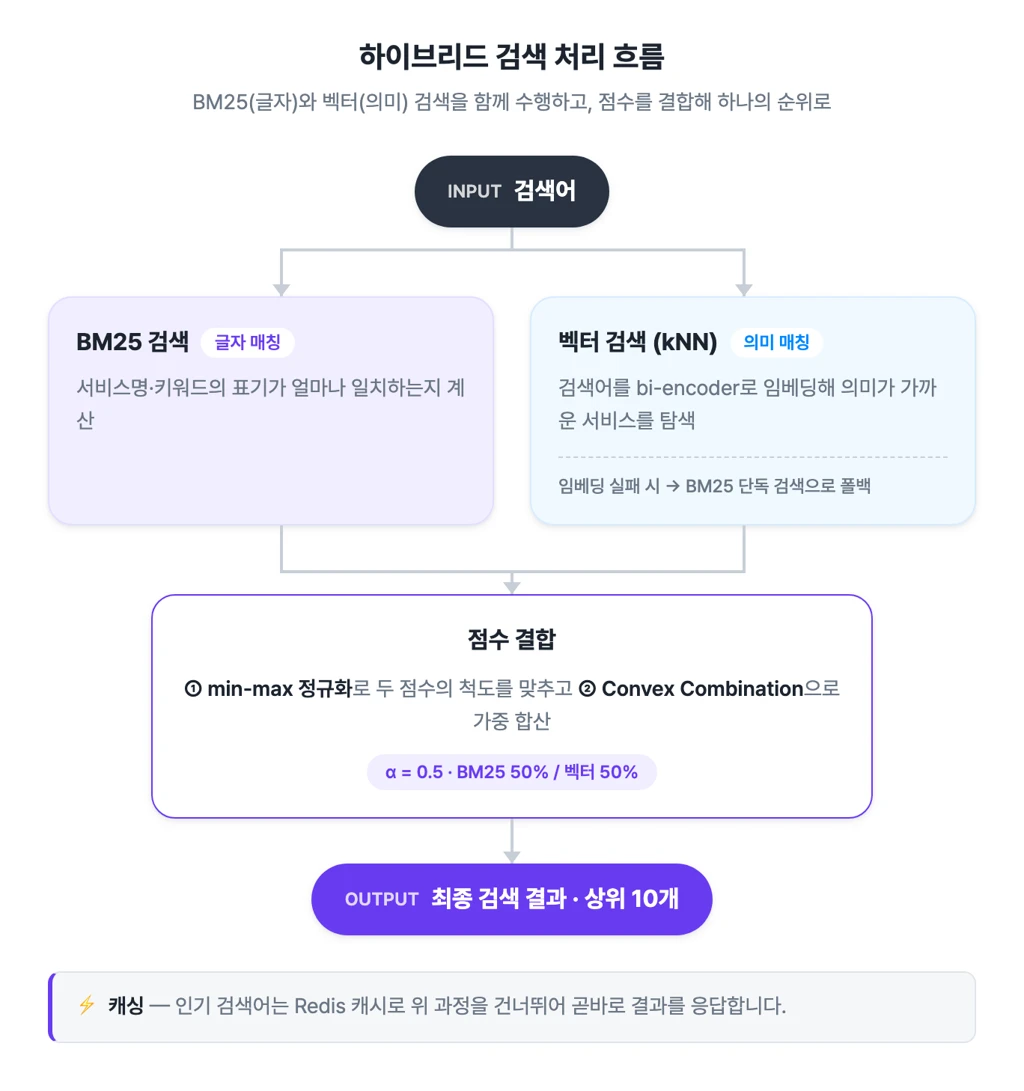
점수 결합: RRF vs Convex Combination
두 검색 결과를 합치는 대표적인 방법으로 RRF(Reciprocal Rank Fusion) 와 Convex Combination(CC) 두 가지를 놓고 고민했습니다.
-
RRF : 각 검색 결과의 순위(rank) 만 사용합니다. 점수 대신 "몇 등이었나"를 기준으로
1 / (k + 순위)값을 더해 최종 순위를 만듭니다. 점수의 척도(scale)를 신경 쓸 필요가 없어 구현이 간단하고, 별도 튜닝 없이도 안정적으로 잘 동작하는 강력한 기본값입니다.*
k는 하위 순위 문서를 얼마나 반영할지 조절하는 상수로, 보통 60을 씁니다. -
CC : 각 검색의 실제 점수를 가중 합산합니다.
최종 점수 = α × (정규화된 BM25 점수) + (1 - α) × (정규화된 벡터 점수)
CC는 순위만 쓰는 RRF와 달리 점수 차이의 크기까지 반영할 수 있어, 잘 튜닝하면 더 좋은 품질을 낼 여지가 있습니다. (Elasticsearch 공식 블로그에서도 RRF는 별도 튜닝이 필요 없는 강력한 기본값이지만, 가중치를 잘 조정하면 CC가 RRF보다 더 나은 성능을 낼 수 있다고 설명합니다.)
우리는 RRF와 CC를 여러 가중치 조건으로 테스트하고, 그 결과를 Data Scientist 그리고 Product Owner와 함께 분석한 끝에 CC(α=0.5, BM25 50% / 벡터 50%) 값을 선택했습니다. RRF의 간편함도 매력적이었지만, 우리 검색 데이터에서는 점수 크기를 반영한 CC가 더 자연스러운 순위를 만들어냈고, 앞으로 가중치를 조정하며 품질을 세밀하게 개선할 여지가 크다는 점이 결정적이었습니다.
CC를 쓰려면 먼저 두 점수의 척도를 맞춰야 합니다. BM25 점수는 검색어와 문서에 따라 스케일이 달라져 정해진 범위가 없는 반면, 코사인 유사도는 항상 일정한 범위 안에 들어옵니다. 그래서 각 점수를 min-max 정규화로 0~1 범위에 맞춘 뒤 결합합니다. α는 글자 매칭의 정확성과 의미 매칭의 유연함 사이에서 균형을 맞추는 0.5에서 시작했고, 이후 검색 품질을 모니터링하며 조정 가능한 값으로 두었습니다.
아래는 이해를 돕기 위해 핵심만 간추린 예시 코드입니다.
from collections import defaultdict

def min_max_normalize(scores):
    if not scores:
        return []

    lo, hi = min(scores), max(scores)
    if hi == lo:  # 모두 같은 점수면 균등 처리
        return [1.0] * len(scores)

    return [(s - lo) / (hi - lo) for s in scores]

def convex_combine(bm25_hits, vector_hits, alpha=0.5):
    # 각 검색 결과의 점수를 0~1로 정규화
    bm25_norm = min_max_normalize([h.score for h in bm25_hits])
    vec_norm = min_max_normalize([h.score for h in vector_hits])

    # 문서별 가중 합산
    combined = defaultdict(float)
    for hit, s in zip(bm25_hits, bm25_norm):
        combined[hit.id] += alpha * s
    for hit, s in zip(vector_hits, vec_norm):
        combined[hit.id] += (1 - alpha) * s

    # 최종 점수 기준 내림차순 정렬
    return sorted(combined.items(), key=lambda x: -x[1])
인덱스와 임베딩 파이프라인
벡터 검색을 위해 Elasticsearch의 기존 BM25 필드에 1024차원 dense_vector 필드를 더한 신규 인덱스를 구성했습니다. 이 필드에는 아래처럼 HNSW 인덱스를 설정했습니다.
{
  "mappings": {
    "properties": {
      "service_vector": {
        "type": "dense_vector",
        "dims": 1024,
        "index": true,
        "similarity": "cosine",
        "index_options": {
          "type": "hnsw",
          "m": 16,
          "ef_construction": 100
        }
      }
    }
  }
}
similarity: cosine는 벡터 간 유사도를 코사인 유사도로 계산하겠다는 의미이고, hnsw는 대규모 벡터 집합에서도 근사 최근접 이웃(ANN)을 빠르게 찾아주는 인덱스 구조입니다. BM25용 필드 매핑은 기존 인덱스를 그대로 복제하고, 여기에 service_vector 필드만 추가하는 방식으로 구성했습니다. 참고로 1024차원 벡터는 검색에만 쓰고 응답에 실어 보낼 필요는 없어, 검색 응답에서는 이 필드를 제외해 네트워크·직렬화 비용을 줄였습니다.
검색어 임베딩은 사내 AI 모델 서비스의 bi-encoder를 동기 호출해 생성합니다. 이 호출은 외부 의존성이므로, 만약 임베딩 생성에 실패하더라도 검색 자체가 멈춰서는 안 됩니다. 그래서 임베딩에 실패하면 BM25 단독 검색으로 자연스럽게 폴백하도록 설계했습니다. 벡터 검색이라는 '의미 이해' 레이어를 얹지 못하는 상황이 되더라도, 사용자는 검증된 BM25 검색 결과를 항상 응답으로 보장받습니다. 이때 폴백은 조용히 넘어가지 않고 로그·메트릭으로 남겨 벡터 검색이 빠진 상황을 팀이 즉시 감지하고 대응할 수 있게 했습니다. 하이브리드로 품질을 높이되, 안정성은 기존 수준 그대로 지키는 방향입니다.
성능: 자주 찾는 검색어는 캐싱으로
하이브리드 검색은 검색어를 임베딩으로 변환하고, 벡터·텍스트 검색을 함께 수행하는 만큼 기존 BM25 단독 검색보다 손이 더 갑니다. 매 검색마다 이 과정을 처음부터 반복하면 응답 속도에도, AI 모델 서비스 부하에도 부담이 됩니다.
그런데 실제 검색 트래픽을 보면 인기 검색어는 같은 검색어가 반복해서 들어오는 경우가 많습니다. 그래서 검색 결과를 Redis에 캐싱해 같은 검색어의 반복 요청을 빠르게 처리하도록 했습니다.
- 검색어 → 서비스 ID 목록만 캐싱합니다. 서비스의 이름·카테고리 같은 상세 정보는 캐싱하지 않고, ID 목록만 저장한 뒤 실제 응답을 만들 때 최신 정보로 다시 채웁니다. 덕분에 서비스 정보가 바뀌어도 캐시 때문에 옛 정보가 나가는 일이 없습니다
- 캐시가 적중하면 검색어 임베딩 생성과 검색 두 단계를 모두 건너뛰므로, 응답이 빨라지고 AI 모델 서비스 호출량도 크게 줄어듭니다
- 앞서 설명한 BM25 폴백 결과는 캐싱하지 않습니다. 벡터 검색이 빠진 '차선책' 결과가 캐시에 굳어져 한동안 노출되는 것을 막기 위해서입니다. 폴백 상황이 정상화되면 자연스럽게 다시 하이브리드 결과가 캐싱됩니다
작은 장치지만, 하이브리드 검색으로 늘어난 비용을 상쇄하면서도 검색 품질은 그대로 지키는 실용적인 선택이었습니다.
Cross-Encoder를 도입하지 않은 이유
검색 품질을 이야기할 때 자주 등장하는 기술이 Cross-Encoder(CE) 입니다. 1차 검색으로 후보를 추린 뒤, CE로 검색어와 각 후보를 함께 입력해 정밀하게 재순위(re-ranking) 하는 방식으로, 품질을 크게 끌어올릴 수 있는 강력한 도구입니다.
당연히 우리도 도입을 검토했고, PoC 단계에서 직접 벤치마크까지 진행했습니다. 하지만 결과를 보고 도입하지 않기로 결정했습니다. 이유는 하나, 속도였습니다.
서비스 검색은 사용자가 검색창에 글자를 입력하는 동시에 서비스 제안이 따라붙어야 하는, 속도가 곧 경험인 화면입니다. CE는 검색어와 후보를 함께 모델에 통과시켜 재순위를 매기는 만큼 연산 비용이 큰데, 벤치마크 결과 재순위에 CE를 태우면 우리가 지키려던 기준 응답 시간을 크게 초과했습니다. 품질을 위해 검색이 눈에 띄게 느려진다면, 그건 검색 경험 자체를 해치는 일이었습니다.
'품질을 최대로 높이는 선택'과 '검색다운 속도를 지키는 선택' 사이에서, 우리는 후자를 택했습니다. 대신 CE 없이도 정확도를 지키기 위해:
- 짧고 모호한 검색어의 정확도는 기존 BM25 쿼리 튜닝과 연관 키워드(mapping_keywords)로 계속 보강하고,
- 의미 파악은 벡터 검색이 담당하도록 역할을 나눴습니다
가장 화려한 기술을 고르는 대신, 우리 서비스의 제약 안에서 가장 효과적인 조합을 고른 셈입니다.
다시 검색해본 '고3'과 '고양이' - 검색에 의미를 포함하다
하이브리드 검색을 적용한 뒤, 앞서 아쉬웠던 검색어들을 다시 입력해 보았습니다.
- 고3 — BM25는 여전히 '3'을 매칭하지만, 벡터가 더한 의미 점수가 함께 반영되면서 입시 준비, 과외 등 검색 의도에 맞는 서비스가 상단으로 올라왔습니다
- 고양이 — 반려동물 케어, 펫 시터, 펫 보험 등 반려동물과 관련된 서비스로 상위 결과가 채워졌습니다
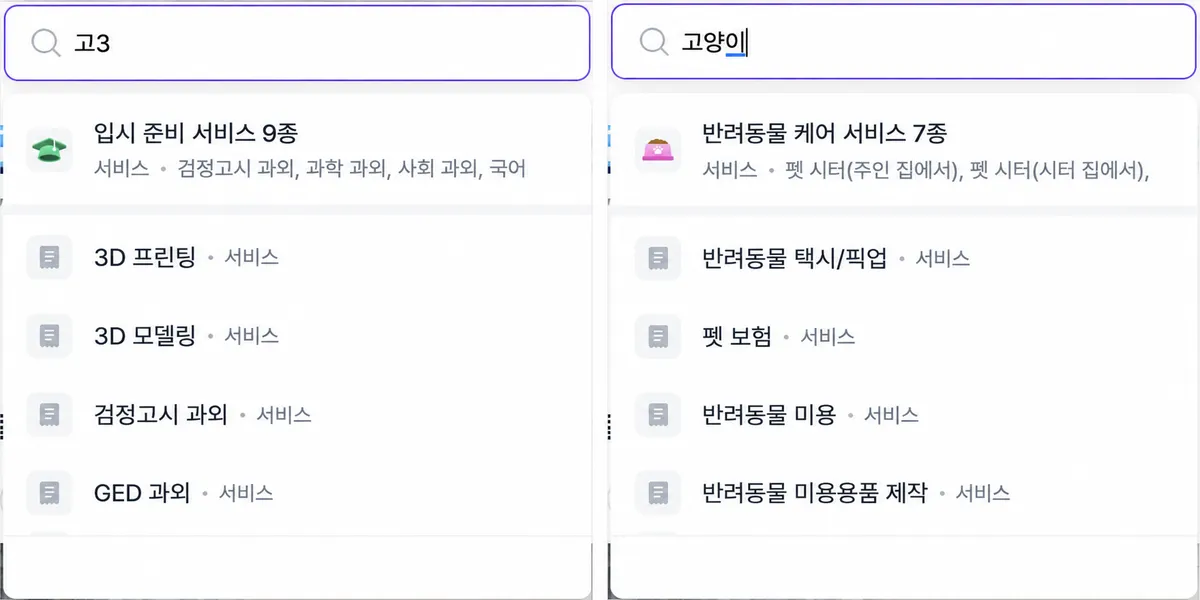
글자만 보던 검색이, 이제 그 안의 의미를 조금씩 읽어내기 시작한 것입니다.
마치며
이번 작업의 목표는 사용자의 검색 의도를 한 걸음 더 이해하는 것이었습니다. 그 과정에서 우리는 다음과 같은 유의미한 결과를 이끌어 낼 수 있었습니다.
- BM25의 강점(정확한 글자 매칭)은 그대로 살리면서,
- 벡터 검색으로 의미 이해를 더하고,
- 검색이라는 화면의 속도 제약을 지키기 위해 Cross-Encoder는 과감히 덜어냈습니다
가장 좋은 기술이 항상 정답은 아니라는 것, 그리고 우리 서비스의 제약과 특성을 정확히 이해하는 것에서 좋은 설계가 시작된다는 것을 다시 확인한 작업이었습니다.
'고3'을 검색하던 수험생에게, '고양이'를 검색하던 집사에게, 이제 검색창은 조금 더 말이 통하는 상대가 되었습니다. 글자를 정확히 맞추는 검색에서 그 안에 담긴 의도를 읽어내는 검색으로 — 이 한 걸음이, 숨고를 찾은 누군가가 필요한 고수를 조금 더 빨리 만나는 순간으로 이어지길 바랍니다.
- #backend
- #elasticsearch
- #python
- #searchengine